14.3. 顺序适配方法
14.3.1. 顺序适配方法
顺序适配方法试图找到一块"合适"的块来满足存储请求。这里描述的三种顺序适配方法都假定空闲块被组织成双向链表,如下图所示。
实现 freelist 有两种基本方法。较简单的方法是把 freelist 与内存池分开存放。也就是说,可以使用简单的链表实现,链表的每个结点包含一个指针,指向内存池中的一个空闲块。如果内存池之外还有空间可供链表本身使用,这就可行。
存储 freelist 的第二种方法更复杂,但节省空间。既然空闲空间是空闲的,内存管理器就可以利用它来完成自己的工作;也就是说,内存管理器临时"借用"空闲块内的空间来维护自己的双向链表。为此,每个未分配块都必须大到足以容纳这些指针。此外,通常值得让内存管理器为每个保留块附加几个字节供自己使用。换句话说,请求 \(m\) 字节的空间可能导致内存管理器实际分配略多于 \(m\) 字节,多出来的字节由内存管理器自己使用而非请求者使用。我们将假定所有内存块都按下图的方式组织,带有标记和链表指针的空间。这里,空闲块和保留块通过位于块首和块尾的标记位来区分,原因稍后解释。此外,空闲块和保留块都在块首标记位之后紧跟一个大小指示器,说明块有多大。空闲块在块尾标记位之前还有第二个大小指示器。最后,空闲块带有指向其在空闲块列表中邻居的左右指针。
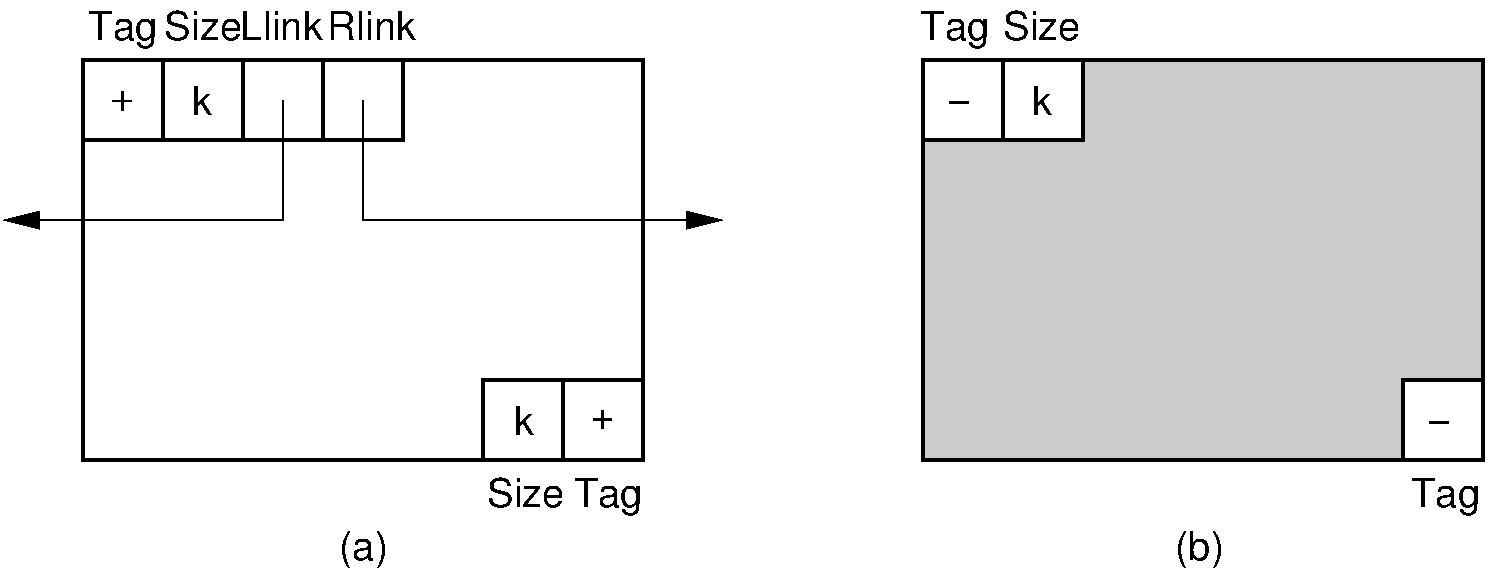
Figure 14.3.1: 内存管理器眼中的块。每个块都包含额外信息,如 freelist 链接指针、首尾标记、以及大小字段。 (a) 空闲块的布局。块首包含标记位字段、块大小字段和 freelist 的两个指针。块尾包含第二个标记字段和第二个块大小字段。 (b) 一个 \(k\) 字节的保留块。内存管理器在这 \(k\) 字节之外,于块首附加了一个标记位字段和块大小字段,并在块尾附加了第二个标记字段。
与每个块关联的信息字段使内存管理器能够按需分配和释放块。当 \(m\) 个字的存储请求到来时,内存管理器在空闲块链表中搜索,直到找到一个"合适"的块用于分配。如何判定哪块合适将在下面讨论。如果该块恰好包含 \(m\) 个字(外加标记和大小字段的空间),就把它从 freelist 中移除。如果该块(大小为 \(k\))足够大,则剩余的 \(k - m\) 个字被保留为 freelist 上当前位置的一个块。
当块 \(F\) 被释放时,必须把它合并进 freelist。如果我们不在乎合并相邻的空闲块,那这就是向空闲块双向链表的一次简单插入。但我们希望合并相邻的块,因为这使内存管理器能够服务尽可能大的请求。由于每个块的端点都存有标记和大小字段,合并很容易完成,如下图所示。内存管理器首先检查紧邻块 \(F\) 之前的内存单元,看前一个块(记为 \(P\))是否也空闲。如果是,那么 \(P\) 的标记位之前的内存单元存储着 \(P\) 的大小,由此可知该块在内存中的起始位置。于是只需把 \(P\) 的大小扩展到包含块 \(F\)。如果块 \(P\) 不空闲,则直接把块 \(F\) 加入 freelist。最后,我们还要检查块 \(F\) 末尾之后的位。如果该位表明后继块(记为 \(S\))空闲,则把 \(S\) 从 freelist 中移除,并适当扩展 \(F\) 的大小。
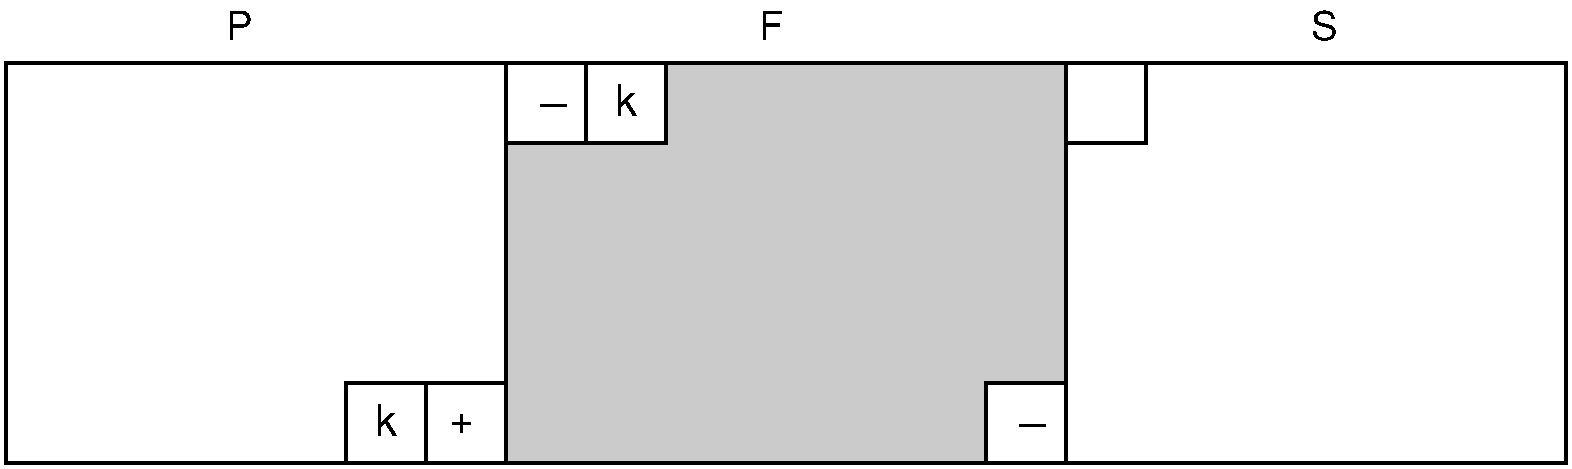
Figure 14.3.2: 把块 \(F\) 加入 freelist。内存池中紧邻 \(F\) 起始位置之前的字存储着前一块 \(P\) 的标记位。如果 \(P\) 空闲,就把 \(F\) 合并进 \(P\)。我们利用 \(F\) 的大小字段找到 \(F\) 的末尾。 \(F\) 末尾之后的字是块 \(S\) 的标记字段。如果 \(S\) 空闲,就把它合并进 \(F\)。
现在考虑如何选择一块"合适"的空闲块来服务内存请求。为了说明这一过程,假设我们有一个 200 个存储单元的内存池。经过一系列分配请求和释放之后, freelist 上有四个空闲块,大小分别为 25、35、32 和 45 (按此顺序)。假设有一个 30 个存储单元的请求。在下面的例子中,我们忽略上述标记、链接和大小字段带来的开销。