10. 失败策略与垃圾回收
在处理过程的某个时刻,内存管理器可能遇到无法满足的内存 请求。 在某些情况下可能无计可施: 空闲内存可能就是不够服务该请求, 而应用又可能要求请求必须立即得到满足。 这时内存管理器别无选择,只能返回错误, 进而可能导致应用程序失败。 然而在许多情况下,除了直接返回错误还有其他选择。 这些可选方案统称为 failure policies。
有些时候,可能有足够的空闲内存满足请求,但它分散在许多小块 之中。 使用顺序适配内存分配方法时可能出现这种情况: 外部碎片 造成了一连串小块,合起来本可以满足请求。 这时,也许可以通过移动保留块来紧凑内存, 把空闲空间收集成单个块。 这种方法的一个问题是:应用程序必须能以某种方式接受自己的 数据全部被移到了不同位置这一事实。 如果应用程序以任何方式依赖数据的绝对位置,那将是灾难性的。 解决该问题的一种办法是使用 handles。 句柄是指向内存位置的二级间接。 内存分配例程不返回指向存储块的指针, 而是返回一个指向变量的指针,该变量再指向存储。 这个变量就是句柄。 句柄的位置从不移动,但块的位置可能被移动,句柄的值随之 更新。 下图说明了这一概念。
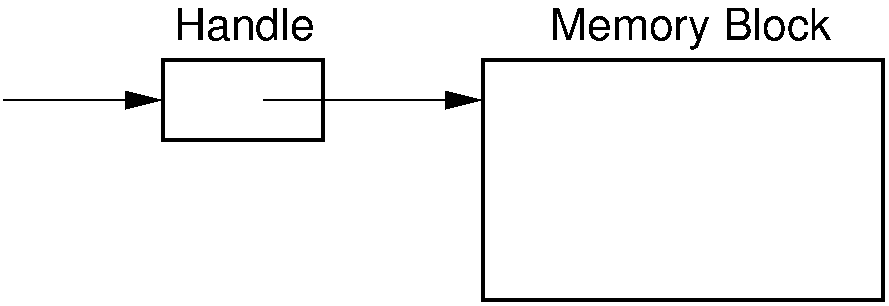
Figure 14.10.1: 在动态内存管理中使用句柄。 内存管理器响应内存请求时返回句柄的地址。 句柄存储实际内存块的地址。 这样,内存块可以被移动(其在句柄中的地址随之更新), 而不会干扰应用程序。
另一种在某些应用中可行的失败策略是推迟内存请求, 直到有足够的内存可用。 例如,多任务操作系统可以采取这样的策略:在内存足够之前, 不允许某个进程运行。 这种延迟虽然可能让用户恼火,但总比停掉整个系统好。 这里的假设是其他进程最终会终止并释放内存。
还有一种选择是给内存管理器分配更多内存。
在 分区 内存分配系统中——内存管理器是更大
系统的一部分——这也许是可行的选择。
在实现自己的内存管理器的 C++ 程序中,
或许可以从系统级的 new 运算符获取更多内存,
freelist 就是这么做的。
我们要考虑的最后一种失败策略是 垃圾回收。 考虑下面的语句序列。:
Integer p = new Integer[5];
Integer q = new Integer[10];
p = q;
在 C++ 这类语言中,这被视为不良写法,
因为第三次赋值使原先分配给 p 的空间丢失了。
程序再也无法使用这块空间。
这种丢失的内存被称为 垃圾,也叫
内存泄漏。
当没有程序变量指向某块空间时,就不可能再访问该空间。
当然,如果先把另一个变量赋为指向 p 的空间,
那么重新赋值 p 就不会产生垃圾。
有些编程语言对垃圾持不同态度。
特别是 LISP 语言使用多链表表示,所有存储要么是带两个指针的
内部结点,要么是原子。
下图展示了以变量 A、B、C 为表头的典型 LISP
结构集合,以及一个 freelist。
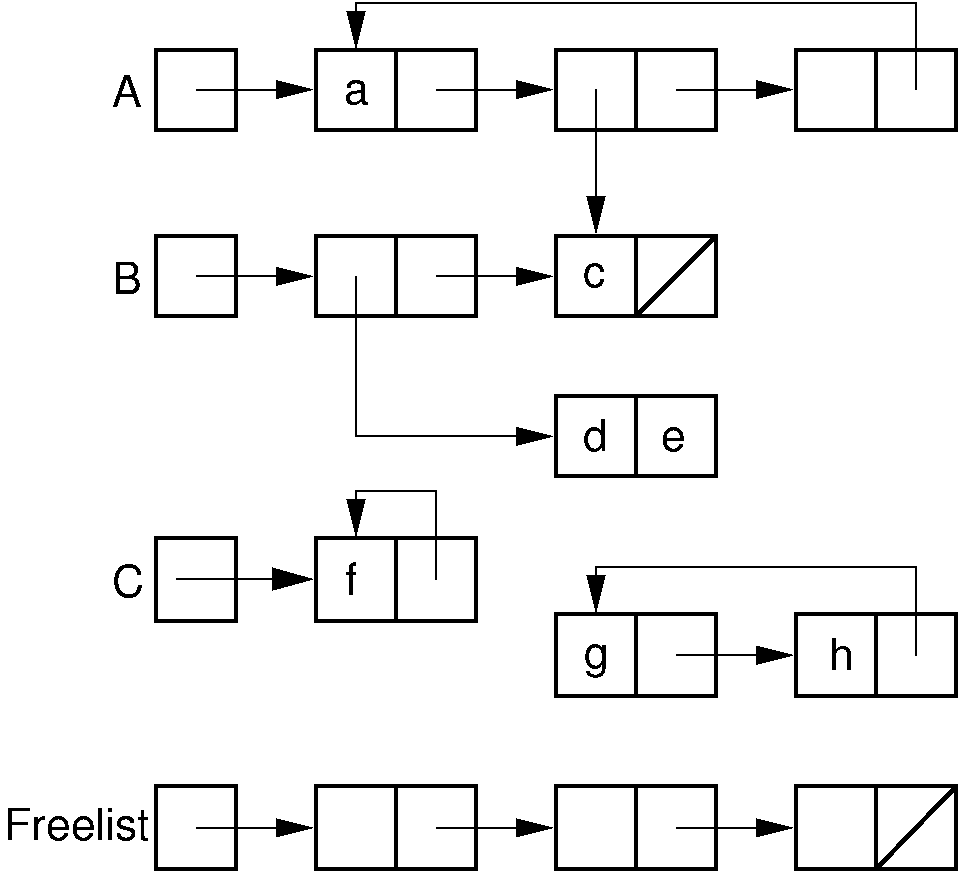
Figure 14.10.2: LISP 列表变量示例,包括系统 freelist。
在 LISP 中,列表对象不断地以各种方式组合成临时变量, 而当对象不再需要时,对它们的所有引用都丢失了。 因此,垃圾在 LISP 中是常态,而且在正常处理中无法避免。 当 LISP 耗尽内存时,它会求助于垃圾回收过程来回收被垃圾占用 的空间。 垃圾回收包括检查受管理的内存池,确定哪些部分仍在使用、哪些 部分是垃圾。 具体做法是:保留一张所有程序变量的列表, 任何无法从这些变量之一到达的内存位置都被视为垃圾。 垃圾回收器执行时,所有未用的内存位置被放入空闲存储以备日后 使用。 这种方法的优点是垃圾回收非常容易。 从用户的角度看,缺点是系统必须不时停下来执行垃圾回收。 例如,在 Emacs 文本编辑器(通常用 LISP 实现)中可以察觉到 垃圾回收。 用户偶尔要等待片刻,等内存管理系统完成垃圾回收。
Java 编程语言同样使用垃圾回收。 与 LISP 一样,Java 的常见做法是按需分配动态内存, 之后丢弃对该内存的所有引用。 垃圾回收器负责按需回收这类未使用的空间。 这可能给程序运行带来额外的时间开销, 但让程序员的日子好过多了。 相比之下,许多用 C++ 编写的大型应用 (甚至是常用的商业软件)都含有内存泄漏, 时间一长就会导致程序失败。
已有多种算法用于垃圾回收。 一种是 引用计数算法。 这里,每个动态分配的内存块都包含一个计数字段的空间。 每当有指针指向某个内存块,引用计数就增加。 每当指针离开某个内存块,引用计数就减少。 如果计数变为零,该内存块就被视为垃圾,立即放入空闲存储。 这种方法的优点是不需要显式的垃圾回收阶段, 因为信息一旦成为垃圾就立即进入空闲存储。
Unix 文件系统使用的就是引用计数算法。 文件可以有多个名字,称为链接。 文件系统为每个文件的链接数维护一个计数。 每当一个文件被"删除",实际上只是它的链接字段减一。 如果该文件还有其他链接,文件系统就不会回收任何空间。 每当链接数降为零,文件的空间就可以复用了。
引用计数有几个主要缺点。 首先,必须为每个内存对象维护一个引用计数。 这在对象较大时(比如文件)效果很好。 但在 LISP 这样的系统中效果不佳,因为内存对象通常只由两个 指针或一个值(原子)构成。 另一个主要问题出现在垃圾包含环的时候。 考虑下图。 这里每个内存对象都被指向一次,但这组对象仍是垃圾, 因为没有指针指向这组对象。 因此,引用计数只有在内存对象以无环方式链接时才有效, 比如 Unix 文件系统,其中文件只能组织成有向无环图。
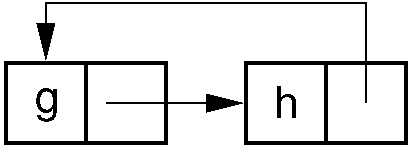
Figure 14.10.3: 垃圾环的例子。 环中的所有内存元素都有非零引用计数, 因为每个元素都有一个指向它的指针, 即使整个环都是垃圾。
垃圾回收的另一种方法是 标记/清除算法。 这里,每个内存对象只需要一个标记位,而不需要引用计数字段。 当空闲存储耗尽时,会执行一个单独的垃圾回收阶段,步骤如下。
清除所有标记位。
从系统变量列表中的每个变量出发,沿着指针执行深度优先搜索 (DFS)。 DFS 遇到的每个内存元素都把标记位打开。
- .# 对内存池做一次"清扫",访问所有元素。
未标记的元素被视为垃圾,放入空闲存储。
标记/清扫方法的优点是所需空间比引用计数少,而且适用于环。 但它有一个主要缺点。 这是处理所需的"隐藏"空间要求。 DFS 是递归算法: 要么递归实现(此时编译器的运行时系统维护一个栈), 要么内存管理器自己维护栈。 如果所有内存都在一个链表里会发生什么? 那么递归的深度(或栈的大小)就是内存单元的数量! 遗憾的是,DFS 栈所需的空间偏偏在最糟糕的时刻——空闲内存 耗尽时——必须可用。
幸运的是,有一个巧妙的技巧可以让 DFS 无需为栈付出额外的 空间。 做法是让被遍历的结构本身来存放栈。 每次向遍历的更深处前进一步时,我们不在栈上存储指针, 而是"借用"正在沿用的那个指针。 把这个指针设置为指向我们在上一步刚经过的结点, 如下图所示。 每个被借用的指针额外存储一位,告诉我们是沿着所指向链结点的 左分支还是右分支下来的。 任一时刻,从根出发只走过一条路径, 我们可以沿指针的踪迹回溯。 返回时(等价于递归栈的出栈), 我们把指针恢复到原位,使结构回到原来的状态。 这就是 Deutsch-Schorr-Waite 垃圾回收算法。
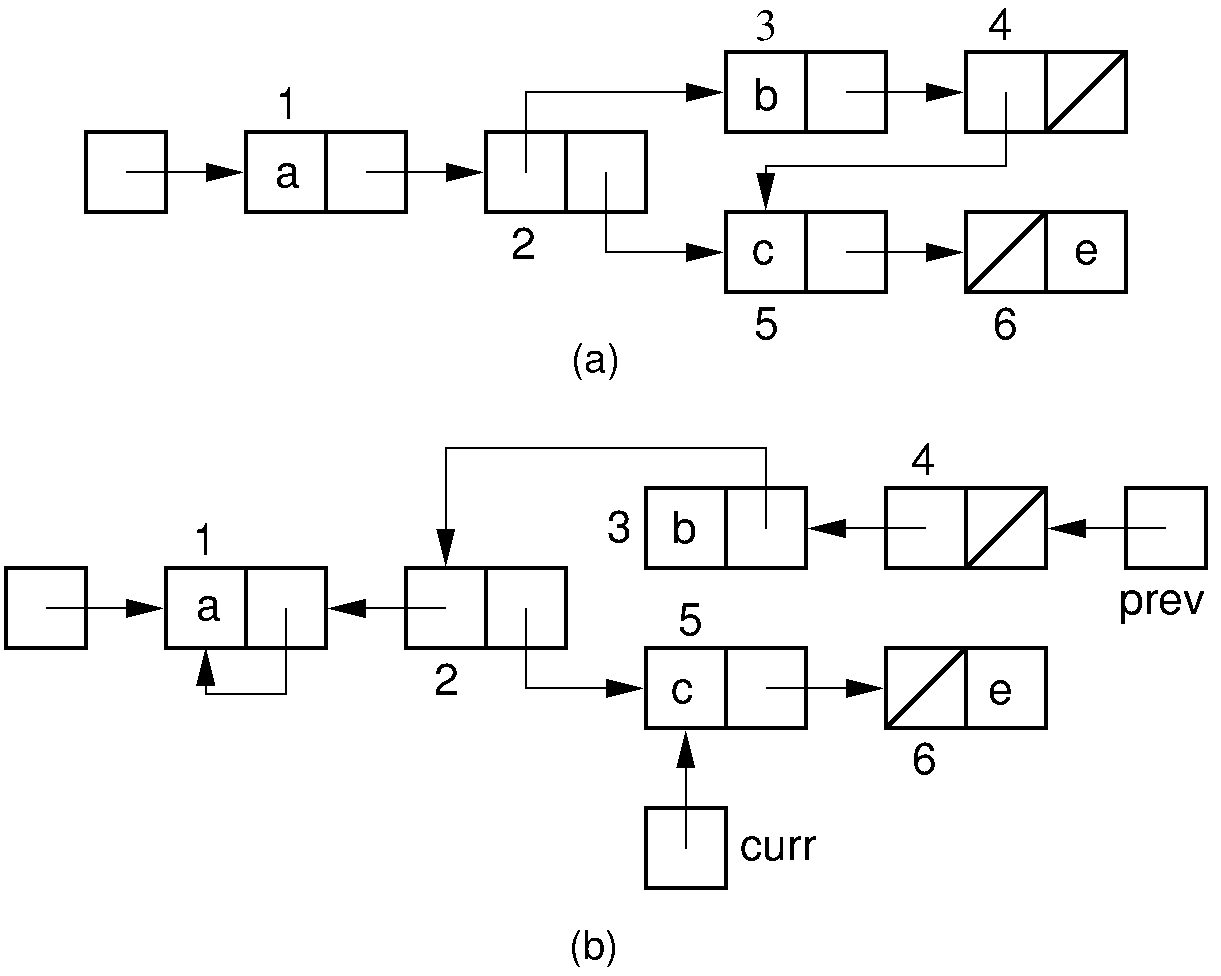
Figure 14.10.4: Deutsch-Schorr-Waite 垃圾回收算法的例子。
(a) 初始的多链表结构。
(b) (a) 的多链表结构在垃圾回收算法处理链结点 5 时的
瞬间。
垃圾回收算法(临时)创建了一条从变量 prev 延伸到结构
头结点的指针链。