8.1. 第 7 周:SQL
8.1.1. 欢迎!
在前几周中,我们向你介绍了 Python,这是一种高级编程语言,它使用了我们在 C 语言中学到的相同构建块。然而,我们引入这门新语言的目的并非仅仅为了学习“又一种语言”。相反,我们这样做是因为某些工具更适合某些任务,而对其他任务则不太适用!
本周,我们将继续学习与 Python 相关的更多语法。
此外,我们将把这些知识与数据结合起来。
最后,我们将讨论 SQL 或 结构化查询语言 ,这是一种用于交互和修改数据的领域专用语言。
总体而言,本课程的目标之一是学习通用编程——而不仅仅是学习本课程所描述的语言中的编程方法。
8.1.2. 平面文件数据库
正如你可能之前所见,数据通常可以用列和行的模式来描述。
像 Microsoft Excel 和 Google Sheets 创建的电子表格可以输出为
csv或 逗号分隔值 文件。如果你查看
csv文件,你会注意到该文件是扁平的,因为所有数据都存储在由文本文件表示的单个表中。我们将这种数据形式称为 平面文件数据库 。所有数据逐行存储。每列由逗号或其他值分隔。
Python 自带对
csv文件的原生支持。首先,下载 favorites.csv 并将其上传到 cs50.dev 内的文件浏览器中。其次,检查此数据时请注意,第一行是特殊的,因为它定义了每一列。然后,每条记录逐行存储。
favorites/favorites0.py
在终端窗口中,输入
code favorites.py并按如下方式编写代码:# Prints all favorites in CSV using csv.reader import csv # Open CSV file with open("favorites.csv", "r") as file: # Create reader reader = csv.reader(file) # Skip header row next(reader) # Iterate over CSV file, printing each favorite for row in reader: print(row[1])
请注意,已导入
csv库。此外,我们创建了一个reader来保存csv.reader(file)的结果。csv.reader函数从文件中读取每一行,而在我们的代码中,我们将结果存储在reader中。因此,print(row[1])将打印来自favorites.csv文件的语言。你可以在此处 here 下载此代码。favorites/favorites1.py
你可以按如下方式改进你的代码:
# Stores favorite in a variable

import csv

# Open CSV file
with open("favorites.csv", "r") as file:

    # Create reader
    reader = csv.reader(file)

    # Skip header row
    next(reader)

    # Iterate over CSV file, printing each favorite
    for row in reader:
        favorite = row[1]
        print(favorite)
请注意,
favorite被存储然后打印。另外,请注意我们使用next函数跳转到读取器的下一行。你可以下载此代码 here 。上述方法的一个缺点是,我们假设
row[1]始终是最受欢迎的。然而,如果列的顺序被调整了,会发生什么情况?favorites/favorites2.py
我们可以修复这个潜在问题。Python 还允许你通过列表的关键码进行索引。按如下方式修改你的代码:
# Prints all favorites in CSV using csv.DictReader

import csv

# Open CSV file
with open("favorites.csv", "r") as file:

    # Create DictReader
    reader = csv.DictReader(file)

    # Iterate over CSV file, printing each favorite
    for row in reader:
        favorite = row["language"]
        print(favorite)
请注意,此示例在 print 语句中直接使用了
language关键码。favorite被赋值为row["language"]。你可以下载此代码 here 。favorites/favorites3.py
这可以进一步简化为:
# Prints all favorites in CSV using csv.DictReader

import csv

# Open CSV file
with open("favorites.csv", "r") as file:

    # Create DictReader
    reader = csv.DictReader(file)

    # Iterate over CSV file, printing each favorite
    for row in reader:
        print(row["language"])
你可以下载此代码 here 。
favorites/favorites4.py
要统计
csv文件中表达的最喜爱语言的数量,我们可以执行以下操作:# Counts favorites using variables import csv # Open CSV file with open("favorites.csv", "r") as file: # Create DictReader reader = csv.DictReader(file) # Counts scratch, c, python = 0, 0, 0 # Iterate over CSV file, counting favorites for row in reader: favorite = row["language"] if favorite == "Scratch": scratch += 1 elif favorite == "C": c += 1 elif favorite == "Python": python += 1 # Print counts print(f"Scratch: {scratch}") print(f"C: {c}") print(f"Python: {python}")
请注意,每种语言都是使用
if语句来计数的。此外,请注意这些if语句中的双等号==。你可以下载此代码 here 。favorites/favorites5.py
Python 允许我们使用字典来统计每种语言的
counts。请考虑以下对我们代码的改进:# Counts favorites using dictionary import csv # Open CSV file with open("favorites.csv", "r") as file: # Create DictReader reader = csv.DictReader(file) # Counts counts = {} # Iterate over CSV file, counting favorites for row in reader: favorite = row["language"] if favorite in counts: counts[favorite] += 1 else: counts[favorite] = 1 # Print counts for favorite in counts: print(f"{favorite}: {counts[favorite]}")
请注意,当关键码
favorite对应的值counts已存在时,该值会递增。若其不存在,则定义counts[favorite]并将其设为 1。此外,格式化字符串已改进以呈现counts[favorite]。你可以下载此代码 here 。favorites/favorites6.py
我们还可以利用
try和except来处理潜在的异常:# Uses try/except instead import csv # Open CSV file with open("favorites.csv", "r") as file: # Create DictReader reader = csv.DictReader(file) # Counts counts = {} # Iterate over CSV file, counting favorites for row in reader: favorite = row["language"] try: counts[favorite] += 1 except KeyError: counts[favorite] = 1 # Print counts for favorite in counts: print(f"{favorite}: {counts[favorite]}")
注意
if和else已被替换为try和except。你可以下载此代码 here 。favorites/favorites7.py
Python 还支持排序
counts。按如下方式改进你的代码:# Sorts favorites by key import csv # Open CSV file with open("favorites.csv", "r") as file: # Create DictReader reader = csv.DictReader(file) # Counts counts = {} # Iterate over CSV file, counting favorites for row in reader: favorite = row["language"] if favorite in counts: counts[favorite] += 1 else: counts[favorite] = 1 # Print counts for favorite in sorted(counts): print(f"{favorite}: {counts[favorite]}")
注意代码底部的
sorted(counts)。你可以下载此代码 here 。favorites/favorites8.py
如果你查看 Python 文档中
sorted函数的参数,你会发现它有许多内置参数。你可以按如下方式利用其中一些内置参数:# Sorts favorites by value using .get import csv # Open CSV file with open("favorites.csv", "r") as file: # Create DictReader reader = csv.DictReader(file) # Counts counts = {} # Iterate over CSV file, counting favorites for row in reader: favorite = row["language"] if favorite in counts: counts[favorite] += 1 else: counts[favorite] = 1 # Print counts for favorite in sorted(counts, key=counts.get, reverse=True): print(f"{favorite}: {counts[favorite]}")
注意传递给
sorted的参数。key参数允许你告诉 Python 你希望使用哪种方法来排序项目。在这种情况下,counts.get用于按值进行排序。reverse=True告诉sorted从大到小排序。你可以下载此代码 here 。你可以了解更多关于 sorted 的信息,请参阅 Python Documentation 。
8.1.3. 关系数据库
Google、X 和 Meta 都使用关系型数据库来大规模存储其信息。
关系型数据库将数据以行和列的形式存储在称为 表 的结构中。
SQL 允许四种类型的命令:
Create
Read
Update
Delete
这四类操作被亲切地称为 CRUD 。
我们可以使用 SQL 语法
CREATE TABLE table (column type, ...);创建一个数据库。但这条命令应该在哪里运行呢?sqlite3是一种具备本课程所需核心功能的 SQL 数据库类型。我们可以在终端中输入
sqlite3 favorites.db来创建 SQL 数据库。当出现提示时,按下y确认我们要创建favorites.db。你会注意到提示符发生了变化,因为我们现在正在使用一个名为
sqlite的程序。我们可以通过输入
.mode csv将sqlite置于csv模式。然后,通过输入.import favorites.csv favorites从我们的csv文件中导入数据。看起来似乎什么都没发生!我们可以输入
.schema来查看数据库的结构。你可以使用语法
SELECT columns FROM table从表中读取条目。例如,你可以输入
SELECT * FROM favorites;,这将打印favorites中的每一行。你可以使用命令
SELECT language FROM favorites;获取数据的子集。SQL 支持许多用于访问数据的命令,包括:
AVG
COUNT
DISTINCT
LOWER
MAX
MIN
UPPER
例如,你可以输入
SELECT COUNT(*) FROM favorites;。此外,你可以输入SELECT DISTINCT language FROM favorites;以获取数据库中各个语言的列表。你甚至可以输入SELECT COUNT(DISTINCT language) FROM favorites;以获取它们的数量。SQL 提供了我们可以在查询中使用的额外命令:
WHERE       -- adding a Boolean expression to filter our data
LIKE        -- filtering responses more loosely
ORDER BY    -- ordering responses
LIMIT       -- limiting the number of responses
GROUP BY    -- grouping responses together
请注意,我们在 SQL 中使用
--来编写注释。
8.1.4. SELECT 语句
例如,我们可以执行
SELECT COUNT(*) FROM favorites WHERE language = 'C';。将显示一个计数。此外,我们可以输入
SELECT COUNT(*) FROM favorites WHERE language = 'C' AND problem = 'Hello, World';。注意AND如何被用来缩小我们的结果范围。类似地,我们可以执行
SELECT language, COUNT(*) FROM favorites GROUP BY language;。这将提供一个临时表,显示语言和计数。我们可以通过输入
SELECT language, COUNT(*) FROM favorites GROUP BY language ORDER BY COUNT(*);来改进这一点。这将按count对结果表进行排序。同样,我们可以执行
SELECT COUNT(*) FROM favorites WHERE language = 'C' AND (problem = 'Hello, World' OR problem = 'Hello, It''s Me');。请注意,这里有两个''标记,以便以不混淆 SQL 的方式使用单引号。此外,我们可以执行
SELECT COUNT(*) FROM favorites WHERE language = 'C' AND problem LIKE 'Hello, %';来查找任何以Hello,(包括空格)开头的问题。我们可以按如下方式对输出进行排序:
SELECT language, COUNT(*) FROM favorites GROUP BY language ORDER BY COUNT(*) DESC;。我们甚至可以在查询中创建别名,就像变量一样:
SELECT language, COUNT(*) AS n FROM favorites GROUP BY language ORDER BY n DESC;。最后,我们可以将输出限制为 1 个或多个值:
SELECT language, COUNT(*) AS n FROM favorites GROUP BY language ORDER BY n DESC LIMIT 1;。请注意,按照惯例,SQL 关键字通常以大写字母输入。
8.1.5. INSERT 语句
我们也可以利用表单
INSERT INTO table (column...) VALUES(value, ...);将INSERT插入到 SQL 数据库中。我们可以执行
INSERT INTO favorites (language, problem) VALUES ('SQL', 'Fiftyville');。你可以通过执行
SELECT * FROM favorites;来验证此收藏项的添加。
8.1.6. DELETE 语句
DELETE允许你删除部分数据。例如,你可以DELETE FROM favorites WHERE Timestamp IS NULL;。这将删除所有Timestamp为NULL的记录。
8.1.7. UPDATE 语句
我们还可以利用
UPDATE命令来更新你的数据。例如,你可以执行
UPDATE favorites SET language = 'SQL', problem = 'Fiftyville';。这将导致更新所有行。请注意,这些查询具有巨大的威力。因此,在现实世界的环境中,你应该考虑谁拥有执行某些命令的权限,以及你是否有可用的备份!
8.1.8. IMDb
我们可以设想一个用于编目各类电视节目的数据库。我们可以创建一个电子表格,包含
title、star、star、star、star以及更多明星等列。这种方法的问题在于存在大量空间浪费。有些节目可能只有一位明星,而另一些则可能有数十位。我们可以将数据库拆分为多个工作表。可以有一个
shows工作表、一个stars工作表和一个people工作表。在people工作表中,每个人都可以拥有一个唯一的id。在shows工作表中,每个节目也可以拥有一个唯一的id。在名为stars的第三个工作表中,我们可以通过包含show_id和person_id来关联人员与节目。虽然这是一种改进,但这仍不是一个理想的数据库。IMDb 提供了一个包含人物、节目、编剧、明星、类型和评级的数据库。这些表之间的关联关系如下:
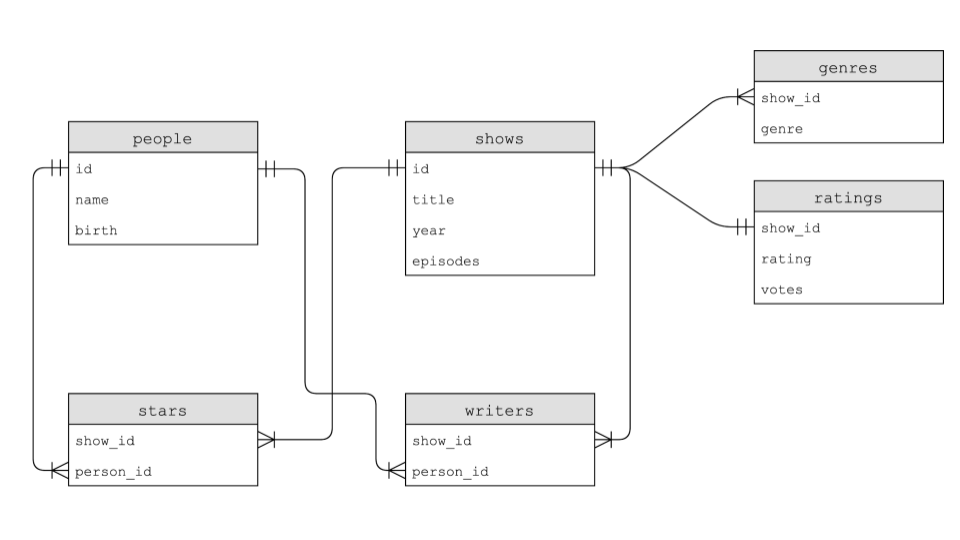
下载 shows.db 后,你可以在终端窗口中执行
sqlite3 shows.db。让我们聚焦于数据库中名为
shows和ratings的两个表之间的关系。这两个表之间的关系可以图示如下: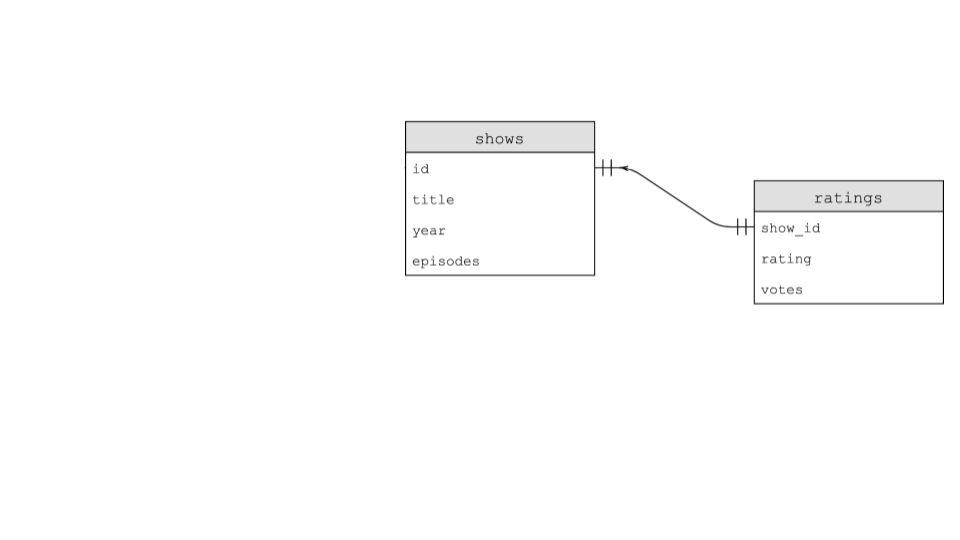
为了说明这些表之间的关系,我们可以执行以下命令:
SELECT * FROM ratings LIMIT 10;。检查输出后,我们可以执行SELECT * FROM shows LIMIT 10;。检查
shows和ratings,我们可以看到它们具有一对一的关系:一个节目对应一个评分。要理解数据库,在执行
.schema后,你不仅会找到每个表,还会找到每个表中的各个字段。更具体地说,你可以执行
.schema shows来理解shows中的字段。你也可以执行.schema ratings来查看ratings中的字段。所有表中都存在对节目 id 的引用。在
shows表中,它简单地称为id。这个所有表共有的字段称为 关键码 。主键用于标识表中的唯一记录。外键 通过指向另一个表中的主键来建立表之间的关系。你可以在ratings的模式中看到,show_id是一个外键,它引用了shows中的id。通过将数据存储在如上所述的关系型数据库中,数据可以更高效地存储。
在 sqlite 中,我们有五种数据类型,包括:
BLOB       -- binary large objects that are groups of ones and zeros
INTEGER    -- an integer
NUMERIC    -- for numbers that are formatted specially like dates
REAL       -- like a float
TEXT       -- for strings and the like
此外,还可以为列设置特殊约束:
NOT NULL
UNIQUE
我们可以进一步处理这些数据以理解这些关系。执行
SELECT * FROM ratings;。这里有大量评分!我们可以通过执行
SELECT show_id FROM ratings WHERE rating >= 6.0 LIMIT 10;进一步限制这些数据。从此查询中,你可以看到展示了 10 个节目。然而,我们不知道每个show_id代表什么节目。你可以通过执行
SELECT * FROM shows WHERE id = 626124;来发现这些是什么节目。我们可以通过执行以下操作来优化我们的查询以提高效率:
SELECT title
FROM shows
WHERE id IN (
    SELECT show_id
    FROM ratings
    WHERE rating >= 6.0
    LIMIT 10
);
请注意,此查询嵌套了两个查询。外部查询使用了内部查询。
8.1.9. JOIN 语句
我们正在从
shows和ratings中提取数据。请注意shows和ratings都有一个共同的id。我们如何临时合并表?可以使用
JOIN命令将表连接在一起。执行以下命令:
SELECT * FROM shows
  JOIN ratings ON shows.id = ratings.show_id
  WHERE rating >= 6.0
  LIMIT 10;
请注意,这会导致表格比我们之前看到的更宽。
前面的查询展示了这些关键码之间的 一对一 关系,现在让我们考察一些 一对多 关系。聚焦于
genres表,执行以下操作:SELECT * FROM genres LIMIT 10;
请注意,这让我们对原始数据有了直观的认识。你可能会注意到,有一个节目包含三个值。这是一种一对多关系。
我们可以通过输入
.schema genres来了解更多关于genres表的信息。执行以下命令以了解数据库中各种喜剧的更多信息:
SELECT title FROM shows
WHERE id IN (
  SELECT show_id FROM genres
  WHERE genre = 'Comedy'
  LIMIT 10
);
请注意,这会生成一个喜剧列表,其中包括 Catweazle 。
我们可以通过连接各种表来了解更多关于 Catweazle 的信息:
SELECT * FROM shows
JOIN genres
ON shows.id = genres.show_id
WHERE id = 63881;
请注意,这会产生一个临时表。拥有重复的表是可以接受的。此外,请注意 Catweazle(一个标题)被分配了 许多 类型,包括冒险、喜剧和家庭。
与一对一和一对多关系不同,还存在 多对多 关系。例如,许多人可能出现在许多节目中!
我们可以通过执行以下命令来了解更多关于节目 The Office 及其演员的信息:
SELECT name FROM people WHERE id IN
    (SELECT person_id FROM stars WHERE show_id =
        (SELECT id FROM shows WHERE title = 'The Office' AND year = 2005));
请注意,这将生成一个包含各种恒星名称的表,这些名称是通过嵌套查询获得的。
我们可以找到所有由史蒂夫·卡瑞尔主演的节目:
SELECT title FROM shows WHERE id IN
    (SELECT show_id FROM stars WHERE person_id =
        (SELECT id FROM people WHERE name = 'Steve Carell'));
这将得到一个由史蒂夫·卡瑞尔主演的节目名称组成的列表。
这可以表示为
JOIN:SELECT title FROM shows JOIN stars ON shows.id = stars.show_id JOIN people ON stars.person_id = people.id WHERE name = 'Steve Carell';
这也可以用这种方式表达:
SELECT title FROM shows, stars, people
WHERE shows.id = stars.show_id
AND people.id = stars.person_id
AND name = 'Steve Carell';
通配符
%运算符可用于查找所有名字以Steve C开头的人,其语法如下:SELECT * FROM people WHERE name LIKE 'Steve C%';。
8.1.10. 索引
虽然关系型数据库比使用
CSV文件更快且更健壮,但可以使用 索引 对表内的数据进行优化。索引可用于加速我们的查询。
我们可以通过在
sqlite3中执行.timer on来跟踪查询速度。要了解索引如何加速查询,请运行以下命令:
SELECT * FROM shows WHERE title = 'The Office';注意查询执行后显示的时间。然后,我们可以使用语法
CREATE INDEX title_index ON shows (title);创建索引。这会指示sqlite3创建索引,并针对此列title执行一些特殊的底层优化。这将创建一个称为 B 树 的数据结构,该结构看起来类似于二叉树。然而,与二叉树不同,它可以拥有两个以上的子节点。
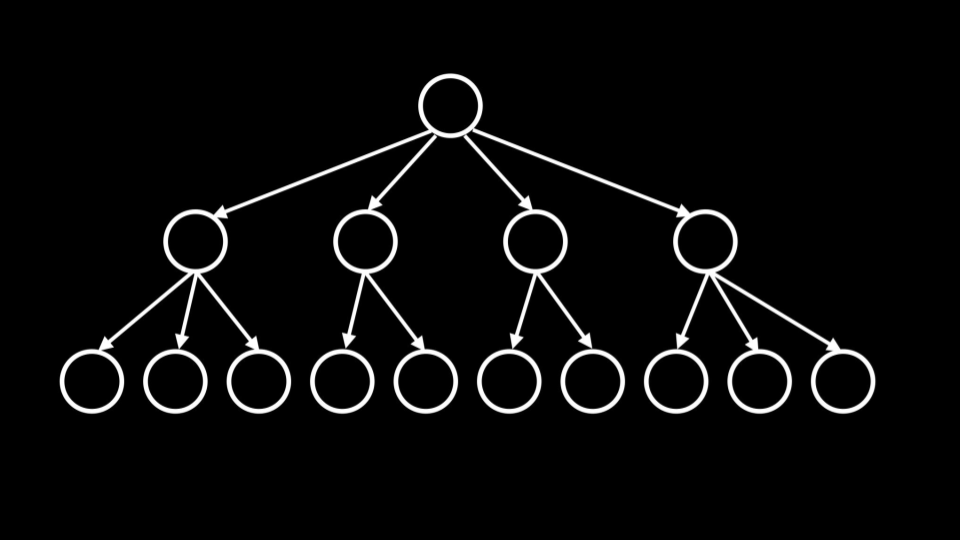
此外,我们可以按如下方式创建索引:
CREATE INDEX name_index ON people (name);
CREATE INDEX person_index ON stars (person_id);
运行该查询,你将注意到查询的运行速度要快得多!
SELECT title FROM shows WHERE id IN
    (SELECT show_id FROM stars WHERE person_id =
        (SELECT id FROM people WHERE name = 'Steve Carell'));
不幸的是,为所有列建立索引将导致占用更多存储空间。因此,提升速度需要权衡。
8.1.11. 在 Python 中使用 SQL
为了协助在本课程中使用 SQL,可以在代码中按如下方式使用 CS50 库:
from cs50 import SQL
与之前使用 CS50 库类似,该库将协助处理在 Python 代码中使用 SQL 的复杂步骤。
你可以在 documentation 中阅读更多关于 CS50 库 SQL 功能的信息。
利用我们的新知识,我们现在可以结合 Python 与 SQL 一起使用。
favorites/favorites10.py
将
favorites.py的代码修改如下:# Searches database for popularity of a problem from cs50 import SQL # Open database db = SQL("sqlite:///favorites.db") # Prompt user for favorite favorite = input("Favorite: ") # Search for title rows = db.execute("SELECT COUNT(*) AS n FROM favorites WHERE problem = ?", favorite) # Get first (and only) row row = rows[0] # Print popularity print(row["n"])
请注意,
db = SQL("sqlite:///favorites.db")向 Python 提供了数据库文件的位置。接着,以rows开头的行利用db.execute执行 SQL 命令。确实,该命令将引号内的语法传递给db.execute函数。我们可以使用此语法发出任何 SQL 命令。此外,请注意rows作为字典列表返回。在此情况下,只有一个结果(一行)作为字典返回到 rows 列表中。你可以下载此代码 here 。
8.1.12. 竞态条件
使用 SQL 有时会导致一些问题。
你可以想象一种情况,多个用户可能同时访问同一个数据库并执行命令。
这可能导致代码被其他人的操作中断而出现错误,从而造成数据丢失。
SQL 内置功能如
BEGIN TRANSACTION、COMMIT和ROLLBACK有助于避免某些此类竞态条件问题。
8.1.13. SQL 注入攻击
现在,仍然考虑上面的代码,你可能会好奇上面的
?个问号是做什么的。SQL 在实际应用中可能出现的问题之一是所谓的 注入攻击 。注入攻击是指恶意行为者可以输入恶意的 SQL 代码。例如,考虑如下登录界面:
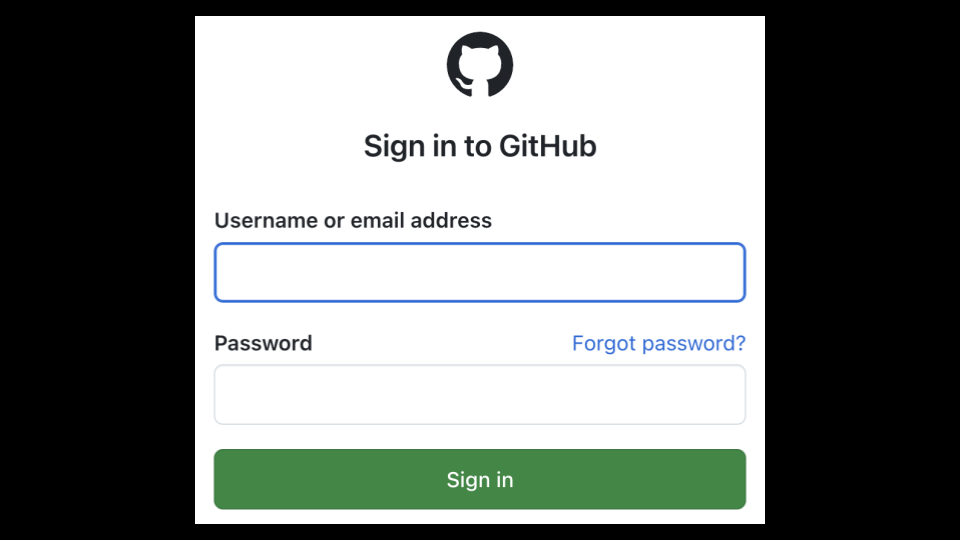
如果我们的代码中没有适当的保护措施,恶意行为者就可能运行恶意代码。请看以下示例:
rows = db.execute("SELECT COUNT(*) FROM users WHERE username = ? AND password = ?", username, password)
请注意,由于
?已就位,验证可以在username和password被查询盲目接受之前运行。切勿盲目信任用户的输入。
利用 CS50 库,该库将 清理 并移除任何潜在的恶意字符。
8.1.14. 总结
在本课中,你学习了更多与 Python 相关的语法。此外,你还学习了如何将这些知识与以平面文件和关系数据库形式存在的数据进行整合。最后,你了解了 SQL 。具体来说,我们讨论了…
平面文件数据库
关系数据库
SQL 命令,例如
SELECT、CREATE、INSERT、DELETE和UPDATE。主键和外键
JOIN索引
在 Python 中使用 SQL
竞态条件
SQL 注入攻击
下次再见!