15.1. 稀疏矩阵
有时我们需要表示一个大型二维矩阵,其中许多元素的值为零。当存储在一个 \(n \times m\) 矩阵中的大部分值都是零,但没有限制哪些位置是零,哪些是非零时,就会出现一个 稀疏矩阵 。
表示稀疏矩阵的一种方法是将行和列坐标拼接(或以其他方式组合)成一个单一的值,并用它作为哈希表中的键。因此,如果我们想知道矩阵中某个特定位置的值,我们就在哈希表中查找相应的键。如果找不到该位置的值,则假定它为零。当对矩阵的所有查询都是按指定位置访问时,这是一种理想的方法。然而,如果我们想查找给定行中的第一个非零元素,或者给定列中当前元素下方的下一个非零元素,或者恢复给定列中的所有非零值,那么哈希表要求我们顺序检查整个表。
另一种方法是将矩阵实现为 正交链表。考虑下面的稀疏矩阵:
对应的正交数组如图所示。这里我们有一个行表头列表,每个行表头都包含一个指针指向矩阵记录列表。第二个列表列表头也包含指向矩阵记录的指针。每个非零矩阵元素存储指向其行中非零邻居(其后和其前)的指针。每个非零元素还存储指向其列中其后和其前的非零邻居的指针。因此,每个非零元素存储它自身的值、它在矩阵中的位置以及四个指针。通过遍历行或列列表找到非零元素。注意,给定行中的第一个非零元素可以在任何列中;同样,任何行或列列表中的相邻非零元素都可以位于数组中的任何(更高的)行或列中。
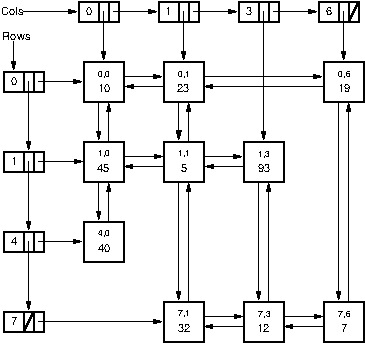
Figure 15.1.1: 一个具有代表性的正交链表稀疏矩阵表示。根据应用的需要,给定的单元格可能存储引用,作为单链表或双链表的一部分,并且单元格可能存储单元格的行/列位置,或者可能存储回行/列表头的引用。
稀疏矩阵的各个(非零)单元格究竟应该存储什么取决于应用。在某些情况下,知道单个单元格的行/列位置很重要。例如,如果我们想对矩阵进行正常的数学运算,例如对以稀疏矩阵表示存储的两个矩阵求和,那么每个单元格比较的一个重要部分是知道在数组的任意自然遍历中我们确切位于何处。因此,每个非零元素都会显式存储其行和列位置。要找出矩阵中某个特定位置是否包含非零元素,我们遍历适当的行或列链表。例如,在查找第 7 行第 1 列的元素时,我们可以遍历第 7 行或第 1 列的链表。当遍历行或列链表时,如果到达一个位置正确的元素,那么它的值非零。如果遇到位置更大的元素,那么我们正在寻找的元素不在稀疏矩阵中。在这种情况下,该元素的值是零。例如,在图的矩阵中遍历第 7 行的链表时,我们首先到达第 7 行第 1 列的元素。如果这正是我们要查找的元素,那么查找可以停止。如果我们要查找第 7 行第 2 列的元素,那么查找沿第 7 行链表继续,接下来到达第 3 列的元素。此时我们知道第 7 行第 2 列没有元素存储在稀疏矩阵中。
在某些应用中,给定的行或列表示关于某个对象的向量信息。例如,考虑我们想要存储关于影评人对电影评分的数据库。如果数据库中有很多电影和很多评分者,那么不会有评分者对很大比例的电影评过分,也不会有电影被很大比例的评分者评过分。所以稀疏矩阵表示可能是理想的,其中每列存储给定评分者的评分信息,每行存储给定电影的评分信息。这允许执行诸如查找某位评分者的所有影评之类的操作,但是, 哪一列 对应哪部电影是任意的。在这种情况下,稀疏矩阵的每个(非零)单元格可能都需要存储对其行和列表头的引用(这些表头可能提供关于记录的进一步信息,例如电影和评论信息),但单元格可能不需要存储无意义的行/列编号。
插入和删除可以通过与在适当的行和列链表中插入或删除元素类似的方式进行。
稀疏矩阵表示中存储的每个非零元素比简单 \(n \times n\) 矩阵中存储的元素占用更多的空间。稀疏矩阵什么时候比标准表示更节省空间?要计算这一点,我们需要确定标准矩阵需要多少空间,以及稀疏矩阵需要多少空间。稀疏矩阵的大小取决于非零元素的数量(我们将该值称为 NNZ),而标准矩阵表示的大小不变。我们需要知道指针和数据值的(相对)大小。为简单起见,我们的计算将忽略行和列表头占用的空间(它受稀疏数组中的元素数量影响不大)。
作为示例,假设一个数据值、一个行或列索引和一个指针各需要四个字节。一个 \(n \times m\) 矩阵需要 \(4nm\) 字节。稀疏矩阵每个非零元素需要 28 字节(四个指针、两个数组索引和一个数据值)。如果我们将 \(X\) 设为非零元素的百分比,我们可以求解临界值 \(X\):低于该值时稀疏矩阵表示更节省空间。使用方程 \(28X = 4mn\) 求解 \(X\),我们发现使用这种实现的稀疏矩阵在 \(X < 1/7\) 时更节省空间,即当少于约 14% 的元素非零时。数据值、指针或矩阵索引的相对大小的不同值可能导致两种实现的盈亏平衡点不同。
处理稀疏矩阵所需的时间理想情况下应取决于 NNZ。查找元素时,成本是目标元素所在行或列链表上位于其前面的元素数量。诸如两个矩阵相加等操作的成本在最坏情况下应为 \(\Theta(n + m)\),此时一个矩阵存储 \(n\) 个非零元素,另一个存储 \(m\) 个非零元素。
稀疏矩阵的另一种表示有时称为 Yale 表示。 Matlab 使用类似的表示,主要区别在于 Matlab 表示使用列优先顺序。(科学软件包倾向于面向列的矩阵表示,因为这是要执行操作的主要访问需求。) Matlab 表示使用三个链表存储稀疏矩阵。第一个仅是所有非零元素的值,按列优先顺序排列。第二个链表存储第一链表中每列的起始位置。第三个链表存储每个相应的非零值的行位置。在 Yale 表示中,上图所示矩阵将显示为:
如果矩阵有 \(c\) 列,那么所需的总空间将与 \(c + 2 NNZ\) 成正比。这在空间方面很好。它允许相当快速地访问任何列,并允许轻松处理列上的非零值。然而,它在提供沿行访问值方面做得不好,并且当需要在表示中添加或删除值时简直糟透了。幸运的是,当进行诸如两个稀疏矩阵相加或相乘等计算时,输入矩阵的处理和输出矩阵的构造可以相当高效地完成。