
13. 代码调优与实验分析
13.1. 代码调优与实验分析
在实践中,增长率为 \(\Theta(n)\) 的算法与增长率为 \(\Theta(n \log n)\) 的算法在运行时间上并没有那么大的差别。 然而,增长率为 \(\Theta(n \log n)\) 的算法与增长率为 \(\Theta(n^2)\) 的算法在运行时间上却有巨大的差别。 在你学习常见数据结构和算法的过程中将会看到,许多问题显而易见的解法需要 \(\Theta(n^2)\) 时间, 但它们也存在需要 \(\Theta(n \log n)\) 时间的解法。 例子包括排序和查找,这是两个最重要的计算机问题。
虽然远不如改变算法以降低其增长率那么重要,但"代码调优"也能显著改善运行时间。 代码调优是一门手工优化程序、使其运行更快或需要更少存储的艺术。 对许多程序来说,代码调优可以把运行时间减少一半或更多,或把存储需求削减为原来的一半或更少。 即使是五到十倍的加速也屡见不鲜。 偶尔,你还可以通过把数据的符号表示转换为可以直接计算的数值编码方案,获得更大的加速。
下面是一些通过代码调优加速程序的建议。 最重要的是要认识到,程序中的大多数语句对该程序的运行时间并没有太大影响。 通常只有少数几个关键子例程,甚至可能只是关键子例程中的少数几行关键代码,占据了大部分运行时间。 把一个只占总运行时间 1% 的子例程的运行时间减半,意义不大。 把注意力集中在程序中影响最大的那些部分上。
调优代码时,收集良好的计时统计数据很重要。 许多编译器和操作系统都包含性能分析器和其他专用工具,帮助收集时间和空间使用方面的信息。 在设法让程序更高效时,这些工具是无价之宝,因为它们能告诉你应该把精力投入到哪里。
很多代码调优基于避免工作而不是加速工作的原则。 一种常见情形是,我们可以测试某个条件,从而跳过一些工作。 然而,这样的测试绝不是完全免费的。 必须注意,测试的代价不要超过所节省的工作量。 虽然一次测试可能比潜在节省的工作更便宜,但测试总是必须进行,而工作只能在部分情况下被避免。
小心不要使用让程序变得不可读的技巧。 大多数代码调优不过是清理一个写得很草率的程序,而不是拿一个清晰的程序来添加技巧。 特别是,你应当体会到现代编译器对表达式进行极佳优化的能力。 这里的"表达式优化"指的是重新排列算术或逻辑表达式,使其运行得更高效。 小心不要为了自己优化表达式而损害编译器为你进行此类优化的能力。 始终要通过在更改前后用一组合适的基准输入运行程序,来检验你的"优化"确实改进了程序。 很多时候,我对自己程序中代码调优的正面效果判断有误。 我最常出错的情况就是试图优化表达式。 要想比编译器做得更好是很难的。
时间和空间上最大的改进来自更好的数据结构或算法。 代码调优最重要的规则是:
先调优算法,再调优代码。
13.1.1. 实验分析
渐近算法分析 是一种分析工具,我们用它来对算法的关键方面建模,以确定算法随输入规模增长的增长率。 它已被证明极具实用性,指导开发者使用更高效的算法。 但它实际上是一种 估算 技术,也有其局限性。 这些局限包括小规模问题下的效应、确定具有相同增长率的算法之间更细微的差别,以及为更复杂问题进行数学建模所固有的困难。
分析方法的替代方案是实验方法。 最明显的实验方法就是简单地运行两个竞争者,看看哪个表现更好。 这样我们或许能克服分析方法的不足。
要注意,对程序进行比较计时是一件困难的事,常常会受到由不可控因素(系统负载、所用的语言或编译器等等)引起的实验误差影响。 最重要的顾虑是,你可能会偏向其中一个程序。 如果你有偏向,这必定会反映在计时结果中。 只要看一眼相互竞争的软件或硬件厂商的广告,就应该能让你相信这一点。 编写两个程序来比较性能时最常见的陷阱是:其中一个程序得到的代码调优投入比另一个多,因为代码调优往往能把运行时间减少五到十倍。 如果两个程序的运行时间无论输入规模如何都相差一个常数因子(即它们的增长率相同),那么运行时间的任何差异都可能是由代码调优的不同造成的。 在这种情况下,要对实验比较保持怀疑。
分析方法的另一种途径是模拟。 模拟的思想是用计算机程序对问题建模,然后运行它以获得结果。 在算法分析的语境中,模拟与两个竞争者的实验比较不同,因为模拟的目的是进行可能过于困难的分析。 一个很好的例子出现在下图中。
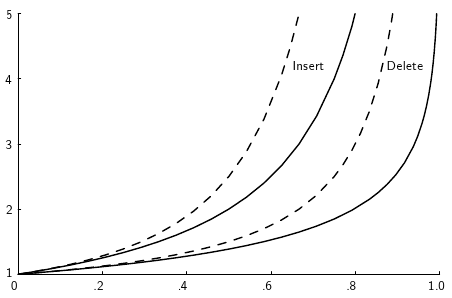
此图展示了在用于在表中寻找空闲槽位的两种不同策略假设下,向 hash table 插入或删除一条记录所需的代价。 \(y\) 轴是以所评估的散列表槽位数目表示的代价,\(x\) 轴是表中已满槽位所占的百分比。 这些曲线的数学方程是可以确定的,但这并不容易。 一个合理的替代方案是编写散列法的简单变体。 通过对各种加载条件下程序的代价进行计时,构造出与此图类似的图并不困难。 这项分析的目的是分析在高效散列系统中应当采用怎样的合适加载因子,以在时间代价与散列表大小(空间代价)之间取得平衡, 而不是确定哪种散列方法最高效,因此我们并不是在对各种散列方案进行实验比较。

