注意:我们将忽略空字符串。在第 9 章中,图灵机的定义假定输入字符串的两侧总是加上空格。如果输入可能是空白符,带头就无法知道输入字符串从哪里开始。要修改定义使其包含空字符串是很容易的,但目前我们只讨论不包含 \(\lambda\) 的语言。
11.2.1.2. 递归可枚举语言的枚举过程
上面的过程不适用,因为对于不在该语言中的字符串, \(M\) 可能不会停机。
要枚举递归可枚举语言 \(L\) 中的所有 \(w \in \Sigma^+\):
永远重复:
* 生成下一个字符串(假设已经生成了 k 个字符串:
\(w_1, w_2, ..., w_k\))
* 在 \(w_k\) 上运行 \(M\) 一步。
在 \(w_{k-1}\) 上运行 \(M\) 两步。
...
在 \(w_{1}\) 上运行 \(M\) \(k\) 步。
如果有任何一个字符串被接受,则把它们写到 2 号带上。
注意:要在恰好这么多步数内被接受!
\[\begin{split}\begin{array}{llll}
1\ \mbox{move} \ w_1 \\
1\ \mbox{move} \ w_2 & 2\ \mbox{moves} \ w_1 \\
1\ \mbox{move} \ w_3 & 2\ \mbox{moves} \ w_2 & 3\ \mbox{moves} \ w_1 \\
1\ \mbox{move} \ w_4 & 2\ \mbox{moves} \ w_3 & 3\ \mbox{moves} \ w_2 & 4\ \mbox{moves}\ w_1 \\
... \\
\end{array}\end{split}\]
问题:
是否存在是 RE 但不是递归的语言?是。
是否存在不是 RE 的语言?是
我们将证明存在一个不是递归可枚举的语言。
备注
问一下什么是幂集。\(2^{\{a,b\}}, 2^{pos. int.}\)
语言是 \(\Sigma^*\) 的子集。| \(\Sigma\) 上所有语言的集合是
\(2^{\Sigma^*}\) 。
\(\Rightarrow\) \(\Sigma\) 上所有语言的集合
是不可数的。
所有图灵机的集合是可数的。| 因此,递归可枚举语言的集合是可数的。| \(\Rightarrow\) 存在不是递归可
枚举的语言。证毕。
接下来的两个定理与上面的定理一起,将说明存在一些递归可枚举但不递归的语言。
存在 \(M_1\) ,使得 \(M_1\) 能够枚举所有
\(L\) 中的元素。
存在 \(M_2\) ,使得 \(M_2\) 能够枚举所有
\(\bar{L}\) 中的元素。
要确定字符串 \(w\) 是否属于 \(L\) 或不属于
\(L\) ,请执行以下算法:
| 重复直到 \(w\) 匹配 | 枚举 \(M_1\) 中的下一个元素 | 枚举 \(M_2\) 中的下一个元素 | | 如果从 \(M_1\) 中枚举出 \(w\) ,则 \(w\) 属于
\(L\) 。如果从 \(M_2\) 中枚举出 \(w\) ,则 \(w\) 不属于 \(L\) 。
对于每个 \(w \in \Sigma^*\) ,我们可以确定 \(w\) 是否
属于 \(L\) 或不属于 \(L\) 。因此, \(L\) 是递归的。证毕。
\(M'\) 可以判断字符串 \(w\) 是否属于
\(\bar{L}\) 或不属于 \(\bar{L}\) 。
因此, \(\bar{L}\) 是递归的。证毕。
如果 \(L\) 不是递归的,那么 \(L\) 和 \(\bar{L}\) 都不可能是 RE。
语言 \(L = \{ a^i | a^i \in L(M_i) \}\) 是 RE 但不是递归的(因为我们证明了它的补不是 RE)。
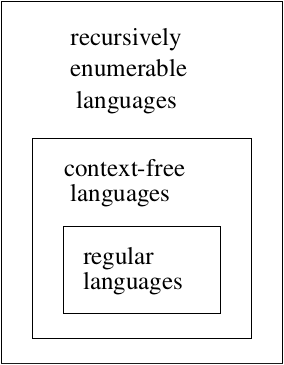
语言的层级:
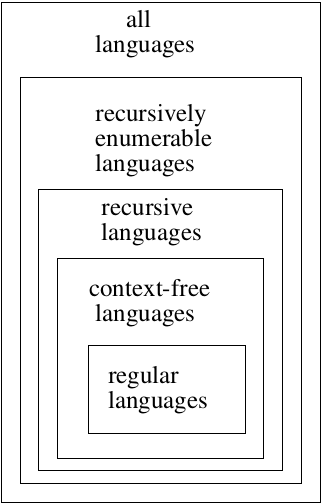
现在我们将讨论与图灵机表示同一种语言的文法。
备注
还要提到 DCFL(处于正则语言和 CFL 之间),以及 CS(处于 CFL 和 REC 之间)。
定义:如果文法 \(G = (V,T,S,P)\) 的所有产生式都有如下形式,则该文法是 无限制的:
其中 \(u \in (V \cup T)^+\),\(v \in (V \cup T)^*\)。
对产生式没有任何限制。左端可以有任意多个变元和终结符。
L 是递归可枚举的。| \(\Rightarrow\) 存在一台图灵机 \(M\) 使得
\(L(M) = L\) 。
\(M = (Q, \Sigma, \Gamma, \delta, q_0, B, F)\) | 思路: \(M\) 从 \(w\) 开始,最终到达
一个终态。
\(q_0w \stackrel{*}{\vdash} x_1q_fx_2\) 对某个
\(q_f \in F, x_1, x_2 \in \Gamma^*\)
构造一个无限制文法 \(G\) 使得
\(L(G) = L(M)\) 。
但在 \(G\) 中,文法从 \(S\) 开始并最终
推导出 \(w\) , \(S \stackrel{*}{\Rightarrow}w\)
因此所构造的文法将逆向模拟该图灵机
的过程。
三个步骤:| 1. \(S \stackrel{*}{\Rightarrow} B \ldots B\#xq_fyB\ldots B\) | 对每种可能的组合使用 \(x, y \in \Gamma^*\) | 2. \(B \ldots B\#xq_fyB\ldots B \stackrel{*}{\Rightarrow} B\ldots B\#q_0wB\ldots B\) | 通过遵循逆向模拟转移的规则。| 3. \(B\ldots B\#q_0wB\ldots B \stackrel{*}{\Rightarrow} w\) | 此处只需移除空白符号,并 \(\# q_0\) 。| 下面是所构造的文法。 | \(G = (V,T,S,P)\) | \(T = \Sigma\) | \(V = \{\Gamma - \Sigma\} \cup Q \{\#\} \cup \{S,A\}\) | \(P\) 对应上述三种情况分别为: | 1. 对于 \(S\stackrel{*}{\Rightarrow}B\ldots B\#xq_fyB\ldots B\) | \(S \rightarrow BS \mid SB \mid \#A\) | 将 \(S\) 替换为大量空白符号,最后加上一个 # ` | :math:` A rightarrow aA mid Aa mid q ` | (对每个 :math:` a in Gamma ` 和 :math:` q in F ` )| 然后生成以
终态结尾的符号字符串。
2. 对于 \(B\ldots B\# xq_fyB\ldots B \stackrel{*}{\Rightarrow} B\ldots B\# q_0wB\ldots B\) | 创建逆向模拟图灵机行为的规则。 | 模拟左移和右移。| 对每个 \(\delta(q_i,a) = (q_j,b,R)\) | 向 \(P\) 、 \(bq_j \rightarrow q_ia\) 添加规则 | 对每个 \(\delta(q_i,a)=(q_j,b,L)\) | 向 \(P\) 、 \(q_jcb \rightarrow cq_ia\) 添加规则,针对每个 | \(c \in \Gamma\) 。 | 3. 对于 \(B\ldots B\# q_0wB\ldots B \stackrel{*}{\Rightarrow} w\) | 为了消除 \(\# q_0\) 和空白符号, | \(\# q_0 \rightarrow \lambda\) | \(B \rightarrow \lambda\) | 然后证明 \(S \stackrel{*}{\Rightarrow} w\) 当且仅当
\(q_0w \stackrel{*}{\vdash} x_1q_fx_2\) 对 \(q_f \in F\)
定义:如果文法 \(G\) 的所有产生式都有如下形式,则它是 上下文相关文法:
其中 \(x,y \in (V \cup T)^{+}\) 且 \(|x|\le |y|\)
可以证明,它们还有另一种等价的定义方式,即所有产生式都有如下形式:
这等价于说,\(A \rightarrow v\) 可以在左侧为 \(x\)、右侧为 \(x\) 的上下文中 应用。
定义:如果存在上下文相关文法 \(G\),使得 \(L = L(G)\) 或 \(L = L(G) \cup \{\lambda\}\),则 \(L\) 是上下文相关语言(CSL)。
在文法的定义中,我们不能有 lambda 规则。
我们在这里加上 \(\lambda\),是为了能声称 CFL \(\subset\) CSL。
定理: 对于每一个不包含 \(\lambda\) 的 CSL \(L\) , \(\exists\) 一个 LBA \(M\) 使得 \(L = L(M)\) 。
定理: 如果 \(L\) 被一个 LBA \(M\) 接受,那么存在一个 CSG \(\exists\) \(G\) ,使得 \(L(M) = L(G)\) 。
定理:每个上下文相关语言 \(L\) 都是递归的。
定理:存在一个不是 CSL 的递归语言。
备注
第 11.3 节讨论上下文相关语言(CSL)。这些语言介于上下文无关语言和递归语言之间。 CSL 和 LBA(线性有界自动机)表示同一类语言。