13.8. 闭哈希分析
13.8.1. 闭哈希分析
哈希的效率如何?我们可以用执行一次操作所需的记录访问次数来衡量哈希的性能。主要关注的操作是插入、删除和查找。区分成功查找和不成功查找是很有用的。在删除一条记录之前,必须先找到它。因此,删除一条记录所需的访问次数等同于成功查找该记录所需的次数。要插入一条记录,必须找到该记录探测序列上的一个空槽位。这等同于对该记录进行一次不成功的查找(回想一下,插入期间对该记录的成功查找应当产生错误,因为不允许把两条具有相同键的记录存储在表中)。
当哈希表为空时,插入的第一条记录总是会发现其起始位置是空闲的。因此,只需一次记录访问就能找到空闲槽位。如果所有记录都存储在其起始位置,那么成功查找也只需一次记录访问。随着表开始被填满,一条记录能够插入其起始位置的概率会降低。如果一条记录哈希到一个已被占用的槽位,那么冲突解决策略必须找到另一个槽位来存储它。查找未存储在起始位置的记录也需要额外的记录访问,因为要沿着该记录的探测序列去查找它。随着表被填满,越来越多的记录可能离其起始位置越来越远。
从这段讨论可以看出,哈希的期望成本取决于表的装满程度。把表的 装填因子 定义为 \(\alpha = N/M\) ,其中 \(N\) 是当前在表中的记录数。
在假设探测序列遵循哈希表中槽位的随机排列的情况下,我们可以解析地推导出插入(或不成功查找)期望成本的估算值,它是 \(\alpha\) 的函数。假设表中每个槽位成为下一条记录起始槽位的概率相等,那么发现起始位置已被占用的概率就是 \(\alpha\) 。同时发现起始位置和探测序列上下一个槽位都已被占用的概率是 \((N(N-1))/(M(M-1))\) 。出现 \(i\) 次冲突的概率是 \((N(N-1) ... (N-i+1))/(M(M-1) ... (M-i+1))\) 。如果 \(N\) 和 \(M\) 都很大,那么它约等于 \((N/M)^i\) 。期望探测次数等于 1 加上对 \(i >= 1\) 时出现 \(i\) 次冲突的概率求和,其结果约为
成功查找(或删除)的成本与最初插入该记录时的成本相同。然而,插入成本的期望值取决于 \(\alpha\) 的取值,不是删除时的取值,而是最初插入时的取值。我们可以通过从 0 积分到 \(\alpha\) 的当前值来推导出这一成本的估算值(本质上是所有插入成本的平均),结果为 \((1/\alpha) \log_e 1/(1-\alpha).\)
重要的是要认识到,这些公式表示的是在不切实际地假设探测序列基于哈希表中槽位的随机排列时,操作的期望成本。这样我们就避免了由不完美的冲突解决策略带来的全部额外开销。因此,这些成本是平均情况下的下界估算。线性探测下真正的平均成本是插入或不成功查找为 \(.5(1 + 1/(1-\alpha)^2)\) ,删除或成功查找为 \(.5(1 + 1/(1-\alpha))\) 。
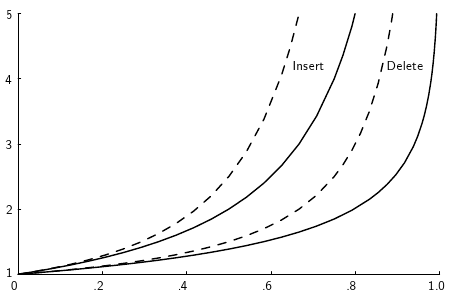
Figure 13.8.1: 一幅图,展示随着装填因子增大,哈希表中插入和删除成本的增长率。
图 13.8.1 展示了随着 \(\alpha\) 增大,期望的记录访问次数如何增长。横轴是 \(\alpha\) 的取值,纵轴是访问哈希表的期望次数。实线表示"随机"探测的成本(理论下界),而虚线表示线性探测的成本(一种相对较差的冲突解决策略)。最左边的两条线表示插入的成本(等价于不成功查找);最右边的两条线表示删除的成本(等价于成功查找)。
从图中可以看出,当表不太满时,哈希的成本通常接近一次记录访问。这是极其高效的,远优于需要 \(\log n\) 次记录访问的二分查找。随着 \(\alpha\) 增大,期望成本也随之增大。对于较小的 \(\alpha\) 值,期望成本较低。在哈希表大约半满之前,它一直低于 2。当表几乎为空时,向表中添加一条新记录不会使未来查找操作的成本增加太多。然而,一旦表变得半满,每次额外插入所引起的额外查找成本就会迅速增加。基于这一分析,经验法则是设计哈希系统时让哈希表永远不要超过大约半满,因为超过这一点后性能会迅速下降。这就要求实现者大致了解在最大装载时表中可能有多少条记录,并据此选择表长。目标应当是:一方面让表足够小,以免浪费大量空间;另一方面又让它足够大,以保持良好性能。