7.3. 哈希函数示例
7.3.1. 哈希函数示例
7.3.1.1. 简单取模函数
考虑下面这个用于把整数哈希到一个具有十六个槽位的表的哈希函数。
这里的 "%" 是取模函数的符号。


回想一下,值 0 到 15 可以用四位表示(即 0000 到 1111)。这个哈希函数返回的值仅取决于键的最低有效四位。由于这些位很可能分布不佳(例如,很大比例的键可能是偶数,这意味着最低位为零),结果也会分布不佳。这个例子表明,表的长度 \(M\) 会对哈希系统的性能产生很大影响,因为表长度通常用作模数,以确保哈希函数产生 0 到 \(M-1\) 范围内的数。
7.3.1.2. 分箱
假设给定 0 到 999 范围内的键,并有一个长度为 10 的哈希表。在这种情况下,一个可能的哈希函数可以简单地把键值除以 100。于是,0 到 99 范围内的所有键都会哈希到槽位 0, 100 到 199 的键会哈希到槽位 1,依此类推。换句话说,这个哈希函数把前 100 个键"分箱"到第一个槽位,接下来的 100 个键到第二个槽位,依此类推。
分箱 这种做法的问题在于,如果分布在高位比特上划分不均匀,它会把键聚集在一起。在上面的例子中,如果键在 900-999 范围内(首位数字为 9)的记录多于键在 100-199 范围内(首位数字为 1)的记录,那么哈希到槽位 9 的记录就会多于哈希到槽位 1 的记录。同样,如果我们为键范围选取的值太大,而实际的键值都相对较小,那么大多数记录都会哈希到槽位 0。如果我们改为根据字符串中的首字母对字符串进行哈希,也会出现类似的问题。
一般来说,使用分箱时,我们把键值为 \(i\) 的记录存储在数组位置 \(i/X\) 处,其中 \(X\) 是某个值(使用整数除法)。分箱的一个问题是,我们必须知道键范围,才能确定 \(X\) 应取什么值。让我们假设键都在 0 到 999 范围内。那么我们希望把键值除以 100,使结果落在 0 到 9 范围内。分箱能处理的键范围没有特别的限制,只要我们事先知道可能的最大值,从而能够确定把键值除以多少。或者,我们也可以对任何分箱计算的结果再对表长度取模以求稳妥。因此,如果键在除以 100 后仍然大于 999,我们仍然可以通过在最后对 10 取模,确保结果落在 0 到 9 范围内。
分箱查看的是键值中与取模函数相反的部分。对于 2 的幂,取模函数查看低位比特,而分箱查看高位比特。或者,如果你想用十进制而不是二进制来思考,对 10 或 100 取模查看低位数字,而分箱到长度为 10 或 100 的数组中查看高位数字。
再举一个例子,考虑对一组值服从正态分布的键进行哈希,如图 7.3.1 所示。接近正态分布均值的键,出现概率远高于接近分布尾部键。对于给定的槽位,想一想键来自分布中的哪个位置。分箱相当于从分布中切出厚厚的切片,把这些切片分配给哈希表的槽位。如果我们使用长度为 8 的哈希表,就会把键范围分成 8 个等宽切片,并把每个切片分配给表中的一个槽位。由于正态分布更可能从中间的切片产生键,表中间的槽位最可能被使用。相比之下,如果我们使用取模函数,那么就是给表中任意给定的槽位分配一系列以 8 为步长的薄切片。在正态分布中,与任意给定槽位相关的这些切片,有些靠近尾部,有些靠近中心。因此,每个表槽位(大致)以相同概率获得一个键值。
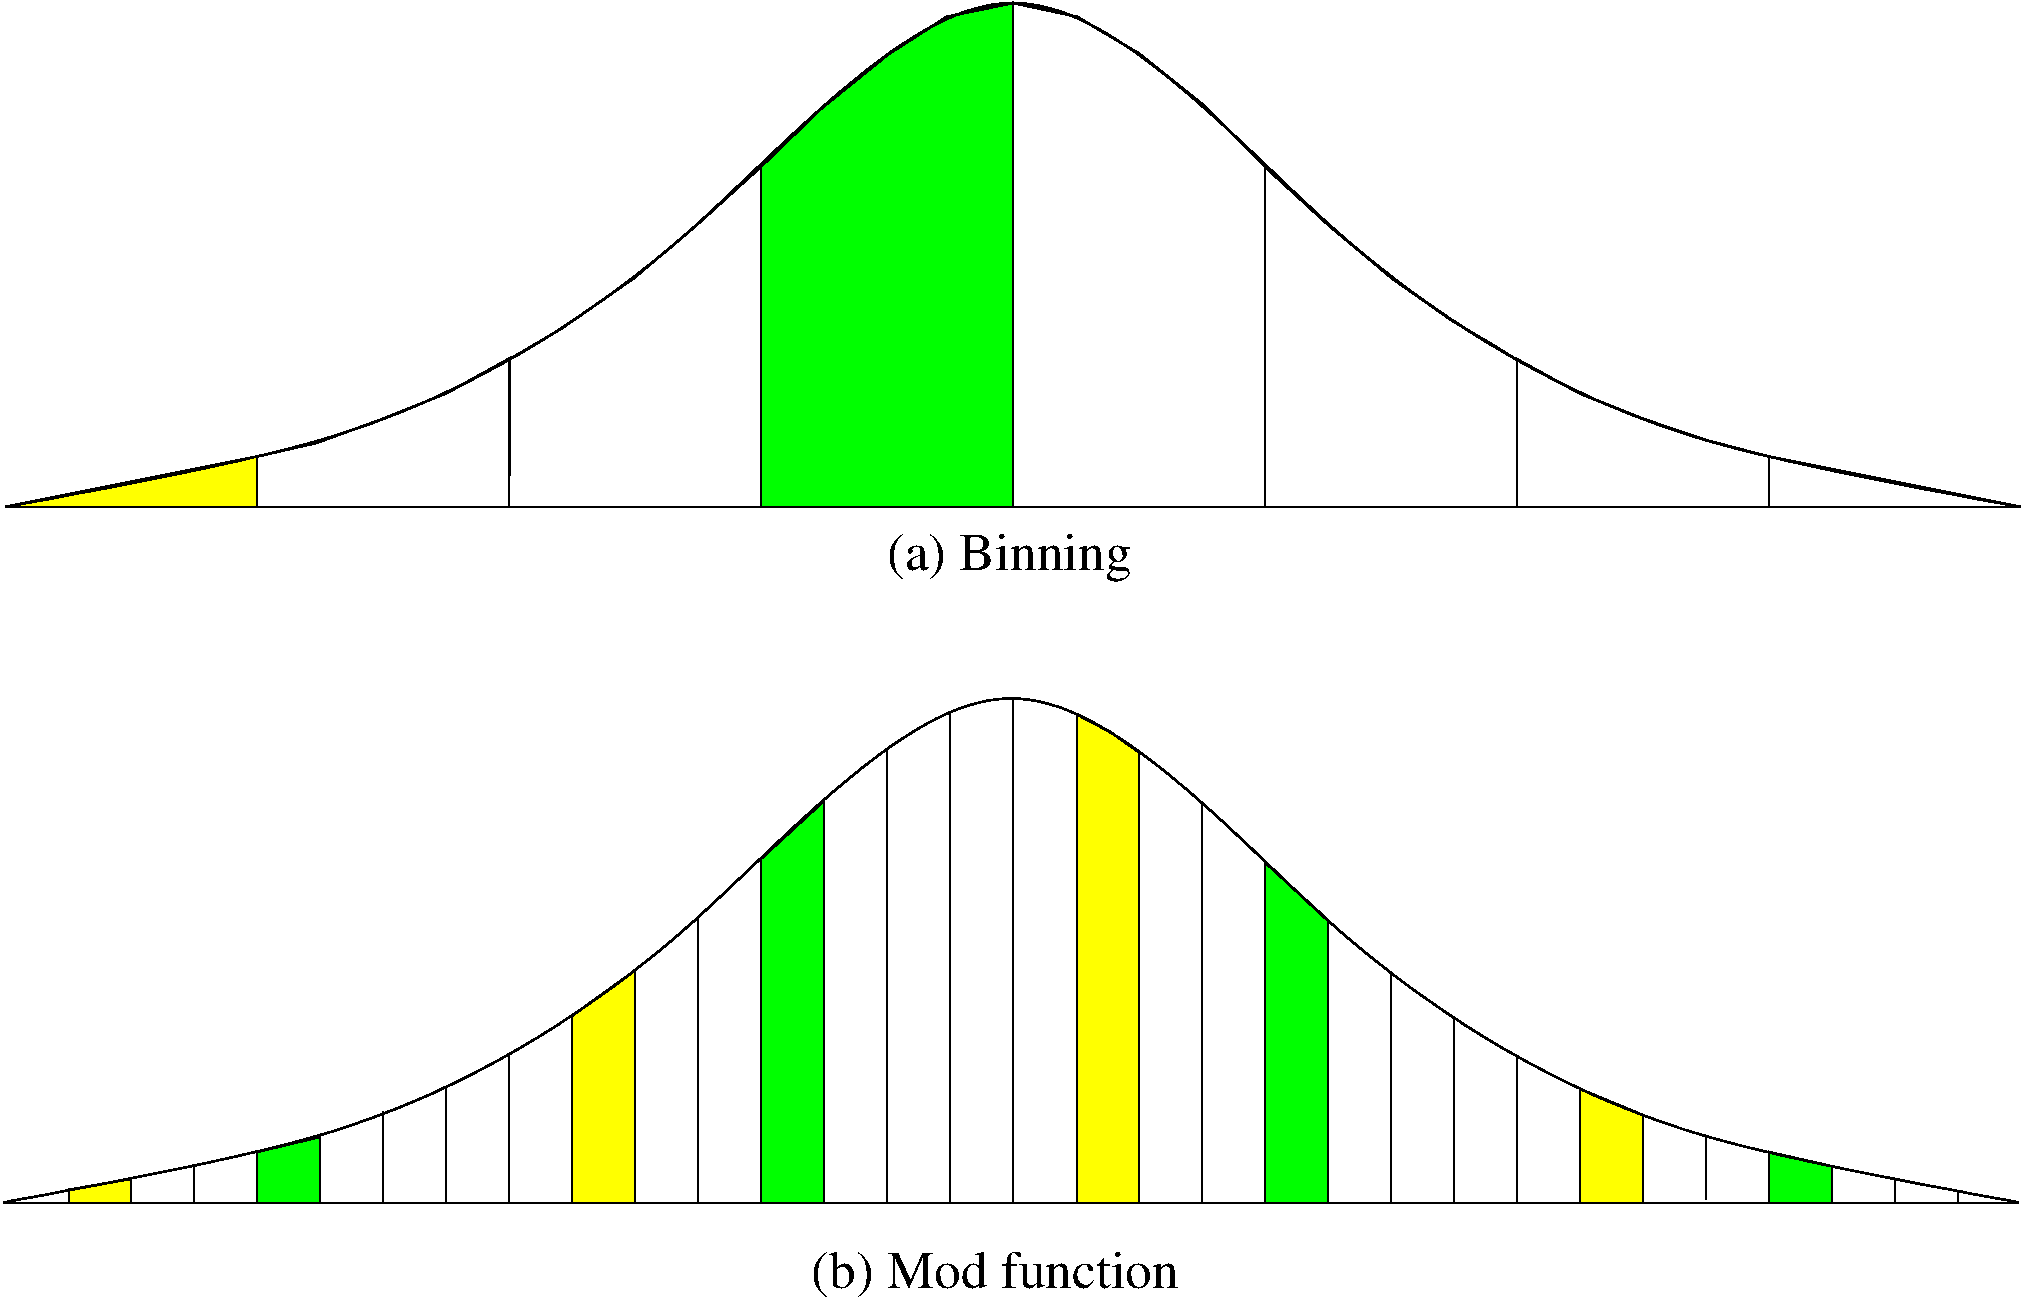
Figure 7.3.1: 作为哈希函数,分箱与取模的比较。
7.3.1.3. 平方取中法
一种适合用于整数键值的好的哈希函数是 平方取中法 。平方取中法把键值平方,然后取出结果的中间 \(r\) 位,得到一个 0 到 \(2^{r}-1\) 范围内的值。这种方法效果很好,因为键值的大部分或全部比特都对结果有贡献。例如,考虑键为十进制 4 位数的记录,如图 7.3.2 所示。目标是把这些键值哈希到一个长度为 100 的表(即 0 到 99 的范围)。这个范围相当于十进制中的两位数字。也就是说, \(r = 2\) 。如果输入是数字 4567,平方得到一个 8 位数 20857489。这个结果的中间两位数字是 57。原始键值的所有数字(等价地,当以二进制查看该数字时的所有比特)都对平方值的中间两位数字有贡献。因此,结果不会由原始键值最低位数字或最高位数字的分布所主导。当然,如果键值都倾向于小数字,那么它们的平方只会影响哈希值的低位数字。
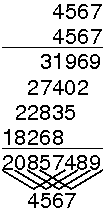
Figure 7.3.2: 一个平方取中法的例子。此图展示了传统的学校式长乘法过程。被平方的值是 4567。平方的结果是 20857489。在图的下方,值 4567 再次显示,每个数字位于一个 "V" 的底部。相关的 "V" 展示了结果中受输入每一位数字影响的那些数字。也就是说,"4" 影响输出数字 2、0、8、5、7。但它对最后 3 位数字没有影响。关键在于,结果的中间两位数字(5 和 7)受到输入每一位数字的影响。
这里有一个小计算器,让你看看它是如何工作的。以 '4567' 为例。
7.3.2. 一个简单的字符串哈希函数
现在我们来研究一些适合存储字符串的哈希函数。我们从一个简单的求和函数开始。
   int sascii(String x, int M) {
     char ch[];
     ch = x.toCharArray();

     int i, sum;
     for (sum=0, i=0; i < x.length(); i++) {
       sum += ch[i];
     }
     return sum % M;
   }
   int sascii(String x, int M) {
     char ch[];
     ch = x.toCharArray();

     int i, sum;
     for (sum=0, i=0; i < x.length(); i++)
       sum += ch[i];
     return sum % M;
   }
这个函数对字符串中字母的 ASCII 值求和。如果哈希表长度 \(M\) 与得到的和相比很小,那么这个哈希函数应当能把字符串很好地均匀分布到哈希表的各个槽位中,因为它对字符串中的所有字符赋予相同权重。这是使用 折叠法 设计哈希函数的一个例子。注意,字符串中字符的顺序对结果没有影响。一种类似的用于整数的做法是把键值的各位数字相加,前提是有足够的数字来
使任何一两位分布不佳的数字不至于使整个过程的结果发生偏斜,并且
生成一个远大于 \(M\) 的和。
与许多其他哈希函数一样,最后一步是使用表长度 \(M\) 对结果应用取模运算符,以生成一个落在表范围内的值。如果和不够大,那么取模运算符会产生很差的分布。例如,因为 'A' 的 ASCII 值是 65,'Z' 是 90,所以对于一个由十个大写字母组成的字符串, sum 的值总是在 650 到 900 范围内。对于长度为 100 或更小的哈希表,会得到合理的分布。对于长度为 1000 的哈希表,分布就很糟糕,因为只有槽位 650 到 900 才可能成为某些键值的归属槽位,而且即便在这些槽位内,值的分布也不均匀。
现在你可以用这个计算器试一试。
7.3.3. 字符串折叠
这是一个好得多的字符串哈希函数。
// Use folding on a string, summed 4 bytes at a time
int sfold(String s, int M) {
  long sum = 0, mul = 1;
  for (int i = 0; i < s.length(); i++) {
    mul = (i % 4 == 0) ? 1 : mul * 256;
    sum += s.charAt(i) * mul;
  }
  return (int)(Math.abs(sum) % M);
}
// Use folding on a string, summed 4 bytes at a time
int sfold(String s, int M) {
  long sum = 0, mul = 1;
  for (int i = 0; i < s.length(); i++) {
    mul = (i % 4 == 0) ? 1 : mul * 256;
    sum += s.charAt(i) * mul;
  }
  return (int)(Math.abs(sum) % M);
}
这个函数以字符串作为输入。它每次处理字符串的四个字节,并把每个四字节块解释为一个长整数值。这些四字节块的整数值相加。最后,用取模运算符把得到的和转换到 0 到 \(M-1\) 范围内。
例如,如果字符串 "aaaabbbb" 传给 sfold ,那么前四个字节("aaaa")会被解释为整数值 1,633,771,873,接下来的四个字节("bbbb")会被解释为整数值 1,650,614,882。它们的和是 3,284,386,755(当作无符号整数处理时)。如果表长度是 101,那么取模函数会使这个键哈希到表中的槽位 75。
现在你可以用这个计算器试一试。
对于任何足够长的字符串,由于得到的值太大,这些整数量的和通常会导致 32 位整数溢出(从而丢失一些高位比特)。但当目标是计算哈希函数时,这不会造成任何问题。
每次对四个字母的整数表示求和来进行哈希,之所以优于每次对一个字母求和,是因为被求和的这些值具有更大的范围。这仍然只对足够长的字符串(比如至少 7-12 个字母)效果良好,但原来的方法对短字符串也同样效果不佳。每次使用四个字符并没有什么特别之处。也可以做出其他选择。另一种替代做法是每次折叠两个字符。
7.3.4. 哈希函数练习
现在这里有一个练习,让你练习这些不同的哈希函数。对于较复杂的哈希函数,你应当使用上面的计算器。
7.3.5. 哈希函数复习题
这里是一些复习题。