
4. 找出第 \(i\) 好的元素
现在我们着手解决在线性表中找出第 \(i\) 好的元素的问题。 这比找出最大值和第二大值更容易还是更难? 这比找出最大值和最小值更容易还是更难? 一方面,它只是一个元素。 另一方面,它似乎可能是更难定位的一个元素。
一种解法是对线性表排序,然后直接看第 \(i\) 个位置。 然而,这一过程提供的信息远远超出我们解决该问题所需。 所以凭直觉,它似乎没有达到可能做到的那样高效。 我们实际需要知道的最少信息量,可以如图 23.4.1 所示来可视化。 也就是说,我们只需要知道比期望值小的 \(i-1\) 个项,以及比期望值大的 \(n-i\) 个项。 我们不关心上下两组内部的相对次序。 那么,我们能比先排序更快地找到所需信息吗? 从下界来看,我们能否把下界收紧到超越显然的 \(n\) 次比较平凡下界? 我们将聚焦于找出中位元素(即秩为 \(n/2\) 的元素)这一具体问题,因为得到的算法可以很容易地推广为对任意 \(i\) 找出第 \(i\) 大的值。
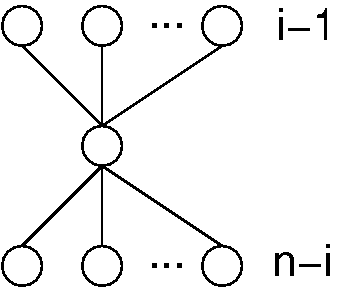
Figure 23.4.1: 表示确定线性表中第 \(i\) 个元素所需最少信息的偏序集。 我们需要知道哪个元素有 \(i-1\) 个值小于它、\(n-i\) 个值大于它,但我们不需要知道那些值小于或大于第 \(i\) 个元素的其他元素彼此之间的关系。
研究 Quicksort 算法或许能为我们解决中位数问题带来一些启发。 回忆 Quicksort 的工作原理:选择一个基准值(pivot),把数组划分成小于基准值和大于基准值的两组元素,并把基准值移动到它在数组中的恰当位置。 划分数组需要 \(O(n)\) 次比较。 如果基准值位于第 \(i\) 个位置,我们就完成了。 如果不在,我们可以只考虑其中一个子线性表,递归地求解该子问题。 也就是说,如果基准值最终落在位置 \(k > i\) ,那么只需在左分划中找出第 \(i\) 好的元素。 如果基准值位于位置 \(k < i\) ,那么我们希望找出右分划中的第 \(i-k\) 个元素。
这个算法的最坏情况代价是多少? 与 Quicksort 一样,如果基准值是数组的第一个或最后一个元素,我们会得到糟糕的性能。 这可能导致 \(O(n^2)\) 的性能。 然而,如果基准值总是把数组分成两半,那么我们的代价就可以用递推关系 \(\mathbf{T}(n) = \mathbf{T}(n/2) + n = 2n\) 来建模,即 \(O(n)\) 代价。
要求平均代价,我们需要使用一个带完整历史的递推关系,类似于我们用来为 Quicksort 代价建模的那个。 如果这样做,我们会发现在平均情况下 \(\mathbf{T}(n)\) 是 \(O(n)\) 的。
有没有可能修改我们的算法以获得最坏情况下的线性时间? 要做到这一点,我们需要选择一个能保证丢弃固定比例元素的基准值。 我们不能随便随机选择一个基准值,因为这样做无法满足这一保证。 理想情况是每次都能选到中位数作为基准值。 但这本质上正是我们一开始想要解决的问题。
然而请注意,如果我们选择任意常数 \(c\) ,然后从规模为 \(n/c\) 的样本中选出中位数,那么我们就能保证至少丢弃 \(n/2c\) 个元素。 实际上,我们可以做得更好:先选出若干规模恒定的小子集(这样我们可以在常数时间内找出其中每个子集的中位数),再取这些中位数的中位数。 图 23.4.2 展示了这一想法。
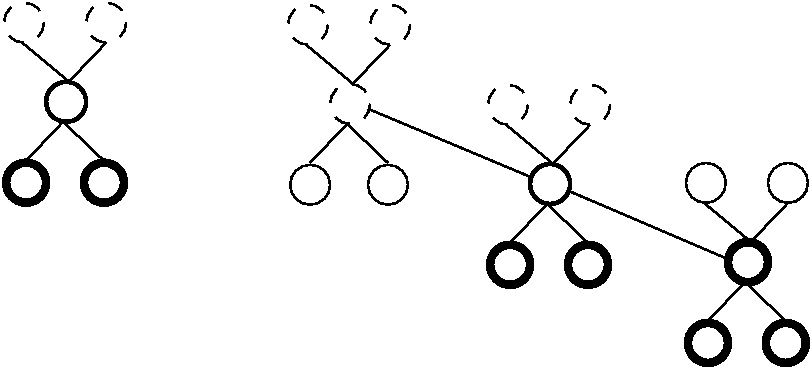
Figure 23.4.2: 一种为划分线性表而寻找基准值的方法,它保证每个分划中至少含有线性表的一个固定比例。 我们把线性表分成每五个元素一组,并找出每组的中位数。 然后我们递归地找出这 \(n/5\) 个中位数的中位数。 五个元素的中位数保证每个分划中至少有两个元素。 由 15 个元素组成的集合中,三个中位数的中位数保证每个分划中至少有五个元素。
这个观察直接引出下面的算法。
从列表中每五个元素一组,选取这些组的 \(n/5\) 个中位数。选取五个元素的中位数可以在常数时间内完成。
递归地,选择 \(M\) ,五项中位数的五项中位数。
将列表划分为大于或等于 \(M\) 的元素和小于 \(M\) 的元素。
虽然以这种方式选择中位数能保证消除一定比例的元素(最多剩下 \(\lceil (7n - 5)/10\rceil\) 个元素),我们仍需确保我们的递归产生一个线性时间的算法。 我们用下面的递推关系对算法建模。
\(\mathbf{T}(\lceil n/5 \rceil)\) 这一项来自计算五元素中位数的中位数, \(6\lceil n/5 \rceil\) 这一项来自计算五元素中位数的代价(每组五个元素恰好需要六次比较), \(\mathbf{T}(\lceil (7n - 5)/10\rceil)\) 这一项来自对可能剩下的(最多)70% 元素的递归调用。
我们将用 构造性归纳 的过程证明这个递推关系是线性的。 我们假设它对某个常数 \(r\) 是线性的,然后证明对所有大于某个界的 \(n\) , \(\textbf{T}(n) \leq rn\) 。
我们可能得稍微搜索一番,才能找到使这个等式成立的 \(r\) 和 \(n\) 值。 例如,如果试 \(r = 1\) ,则得到 \(3.1 n + 7.5 \leq n\) ,显然不成立。 但如果用 \(r = 23\) ,就得到 \(22.9n + 39.5 \leq 23n\) ,这对 \(n \geq 395\) 成立。 这提供了一个基本情况,使我们能用归纳法证明 \(\forall n \geq 395, \mathbf{T}(n) \leq 23n\) 。
虽然我们现在已经证明中位数(或第 \(i\) 个元素)可以在线性时间内求出,但实际上这个算法并不实用,因为它的常数因子代价太高。 为了保证线性时间的性能做了太多工作,以至于平均而言,依靠随机选择基准值反而更高效——或许可以随机挑选基准值,或者从当前子数组中取中间值。
4.1. 鸣谢
本页大量借用 Gregory J.E. Rawlins 所著 Compared to What? 第 3.5 节的内容。

