
3. KD 树(KD Trees)
3.1. KD 树
kd 树 是对 BST 的修改, 允许高效处理 多维查找键。 kd 树与 BST 的不同之处在于,kd 树的每一层 都根据与该层相关的一个特定查找键做出分支决策, 该键称为 判别器。 原则上,kd 树可用于统一任意一组键的查找, 例如名称和邮政编码。 但在实践中,它几乎总是用于支持 多维坐标上的查找,例如二维或三维空间中的位置。 我们将第 \(i\) 层的判别器定义为 \(i\) mod \(k\),其中 \(k\) 为维度数。 例如,假设我们按 \(xy\) 坐标存储数据。 在这种情况下,\(k\) 为 2(有两个坐标), \(x\) 坐标字段被任意指定为键 0, \(y\) 坐标字段被指定为键 1。 在每一层,判别器在 \(x\) 和 \(y\) 之间交替。 因此,第 0 层(根)的结点 \(N\) 的左子树 只包含 \(x\) 值小于 \(N_x\) 的结点(因为 \(x\) 是查找键 0,且 \(0 \mod 2 = 0\))。 右子树包含 \(x\) 值大于 \(N_x\) 的结点。 第 1 层的结点 \(M\) 的左子树只包含 \(y\) 值小于 \(M_y\) 的结点。 \(M_x\) 与 \(M\) 的后代的 \(x\) 值之间没有大小限制, 因为在 \(M\) 处做出的分支决策仅基于 \(y\) 坐标。 图 19.3.1 显示了二维点的集合 如何存储在 kd 树中的示例。
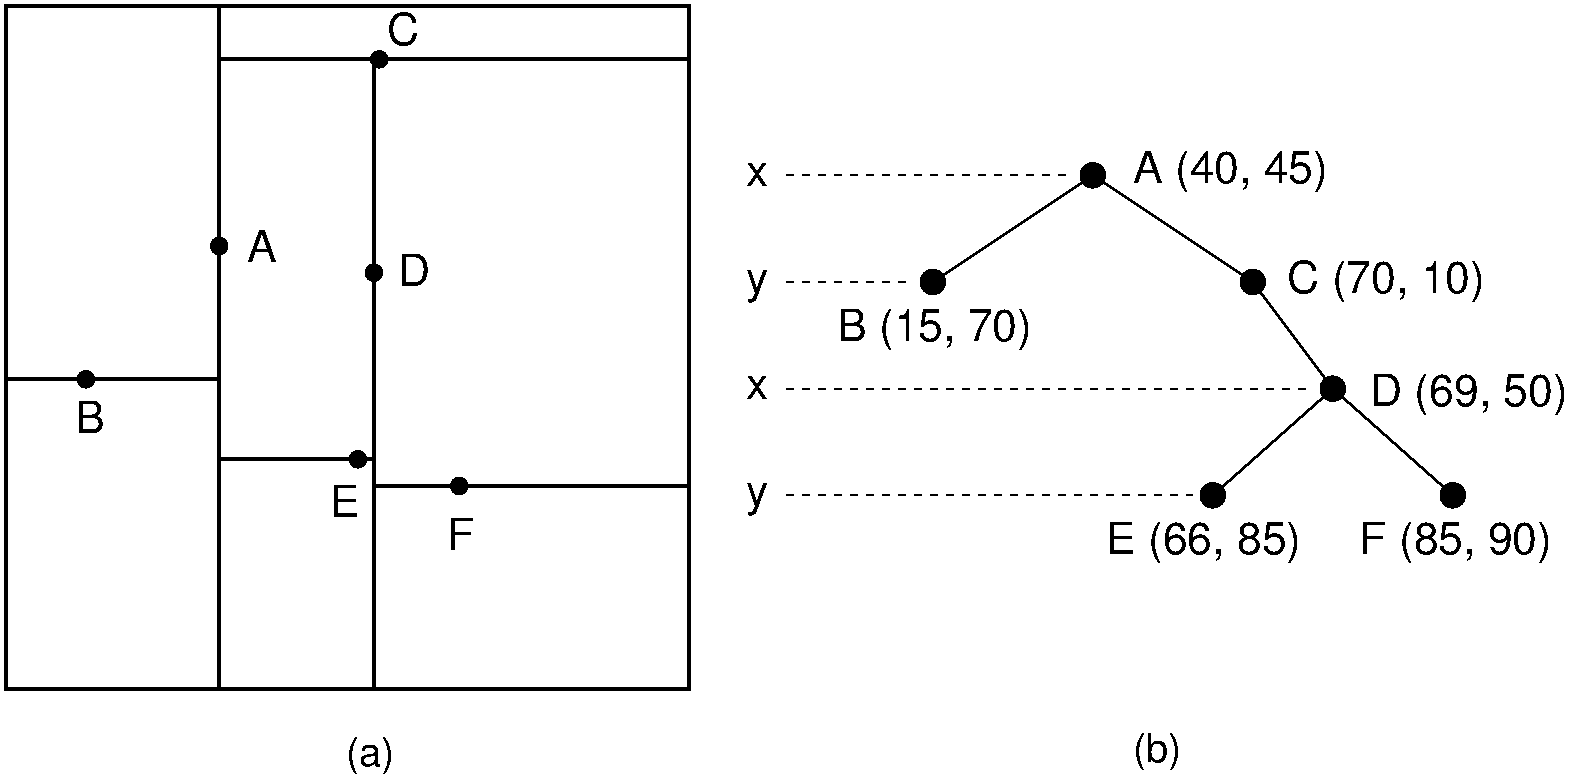
Figure 19.3.1: kd 树的示例。 (a) 一个包含七个数据点的 \(128 \times 128\) 单位区域的 kd 树分解。 (b) 区域 (a) 的 kd 树。
在图 19.3.1 中,包含这些点的区域 被(任意地)限制在 \(128 \times 128\) 的正方形内, 每个内部结点分割查找空间。 每次分割都用一条线表示,判别器为 \(x\) 的结点用垂直线, 判别器为 \(y\) 的结点用水平线。 根结点把空间分成两部分; 它的孩子进一步把空间细分成更小的部分。 孩子的分割线不会与根的分割线交叉。 因此,kd 树中的每个结点都帮助将空间分解成 矩形,这些矩形表明了结点可以落在 各个子树中的范围。
用指定的 xy 坐标在 kd 树中查找记录 就像查找 BST 一样,只是 kd 树的每一层 都与一个特定的判别器相关联。
   private E findhelp(KDNode<E> rt, int[] key, int level) {
     if (rt == null) return null;
     E it = rt.element();
     int[] itkey = rt.key();
     if ((itkey[0] == key[0]) && (itkey[1] == key[1]))
       return rt.element();
     if (itkey[level] > key[level])
       return findhelp(rt.left(), key, (level+1)%D);
     else
       return findhelp(rt.right(), key, (level+1)%D);
   }
向 kd 树中插入新结点类似于
BST 插入。
按照 kd 树的查找过程,直到找到一个 NULL 指针,
该位置即为插入新结点的合适位置。
从 kd 树中删除结点与从 BST 中删除类似,
但稍难一些。
与 BST 删除一样,第一步是找到要删除的结点
(称之为 \(N\))。
然后需要找到 \(N\) 的一个后代,用于
替换树中的 \(N\)。
如果 \(N\) 没有孩子,那么 \(N\) 被替换为
NULL 指针。
注意,如果 \(N\) 有一个孩子而该孩子又有孩子,我们不能
像 BST 中那样简单地让 \(N\) 的父结点指向 \(N\) 的
孩子。
这样做会改变子树中所有结点的层次,从而
用于查找的判别器也会改变。
结果是该子树不再是一棵 kd 树,因为一个
结点的孩子现在可能违反该判别器的 BST 性质。
与 BST 删除类似,存储在 \(N\) 中的记录应被替换为以下两者之一:要么是 \(N\) 右子树中 \(N\) 的判别式值最小的记录,要么是 \(N\) 左子树中该判别式值最大的记录。假设 \(N\) 位于奇数层,因此 \(y\) 是判别式。那么 \(N\) 可以被其右子树中 \(y\) 值最小的记录(称为 \(Y_{min}\) )替换。问题在于, \(Y_{min}\) 不一定是像 BST 中那样的最左侧节点。因此必须使用修改后的搜索过程来查找左子树中最小的 \(y\) 值以找到它。接下来展示了 findmin 的实现。随后通过递归调用删除例程将 \(Y_{min}\) 从树中移除。最后,用 \(Y_{min}\) 的记录替换节点 \(N\) 中的记录。
   private KDNode<E>
   findmin(KDNode<E> rt, int descrim, int level) {
     KDNode<E> temp1, temp2;
     int[] key1 = null;
     int[] key2 = null;
     if (rt == null) return null;
     temp1 = findmin(rt.left(), descrim, (level+1)%D);
     if (temp1 != null) key1 = temp1.key();
     if (descrim != level) {
       temp2 = findmin(rt.right(), descrim, (level+1)%D);
       if (temp2 != null) key2 = temp2.key();
       if ((temp1 == null) || ((temp2 != null) &&
                      (key1[descrim] > key2[descrim]))) {
         temp1 = temp2;
         key1 = key2;
       }
     } // Now, temp1 has the smaller value
     int[] rtkey = rt.key();
     if ((temp1 == null) || (key1[descrim] > rtkey[descrim]))
       return rt;
     else
       return temp1;
   }
在 findmin 中,在使用最小值判别器的层上,
分支向左。
在其他层,必须访问两个孩子的子树。
辅助函数 min 输入两个结点和一个判别器,
返回该判别器上值较小的结点。
注意,只有在右子树存在的情况下, 我们才能用右子树中值最小的结点替换要删除的结点。 如果右子树不存在,那么必须在左 子树中寻找合适的替换。 遗憾的是,用左子树中判别器值最大的记录 替换 \(N\) 的记录并不令人满意, 因为这个新值可能是重复的。 如果是这样,那么 \(N\) 的左子树中将出现相等的判别器值, 这违反了 kd 树的排序规则。 幸运的是,这个问题有一个简单的解决方案。 我们首先将结点 \(N\) 的左子树移到右侧 成为右子树(即,只需交换 \(N\) 的左 右孩子指针的值)。 此时,我们继续正常的删除过程,用 现在成为 \(N\) 的右子树中判别器值 最小 的记录替换要删除的 \(N\) 的记录。
假设我们想打印出所有在给定点 \(P\) 的某一距离 \(d\) 之内的记录列表。 我们将使用欧几里得距离,即点 \(P\) 定义为 在点 \(N\) 的距离 \(d\) 之内, 如果 \(\sqrt{(P_x - N_x)^2 + (P_y - N_y)^2} \leq d.\) [1]
如果查找过程到达一个结点,其判别器的键值 比查找键的对应值高 \(d\) 以上, 那么右子树中任何记录都不可能 在查找键的距离 \(d\) 之内,因为该维度的所有 键值总是太大。 类似地,如果当前结点判别器的键值 比查找键值低 \(d\),那么 左子树中没有记录可以在这个半径内。 在这种情况下,无需查找所涉及的子树, 从而可以节省大量时间。 在平均情况下,区域查询期间必须访问的结点 数量与落在查询圆内的数据记录数量 成线性关系。
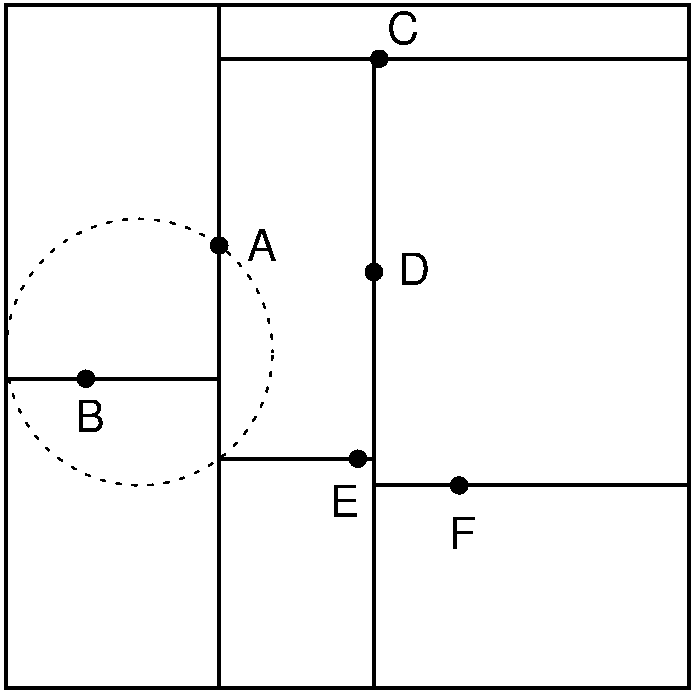
Figure 19.3.2: 在图 19.3.1 的 kd 树中查找。 (a) 一个包含七个数据点的 \(128 \times 128\) 单位区域的 kd 树分解。 (b) 区域 (a) 的 kd 树。
下面是区域查找方法的实现。
   private void rshelp(KDNode<E> rt, int[] point,
                       int radius, int lev) {
     if (rt == null) return;
     int[] rtkey = rt.key();
     if (InCircle(point, radius, rtkey))
       System.out.println(rt.element());
     if (rtkey[lev] > (point[lev] - radius))
       rshelp(rt.left(), point, radius, (lev+1)%D);
     if (rtkey[lev] < (point[lev] + radius))
       rshelp(rt.right(), point, radius, (lev+1)%D);
   }
访问结点时,使用函数 InCircle 来
检查结点的记录与查询点之间的欧几里得距离。
仅仅检查 \(x\) 坐标差和 \(y\) 坐标差
是否都小于查询距离是不够的,因为该记录仍可能位于查找
圆之外,如图 19.3.3 所示。
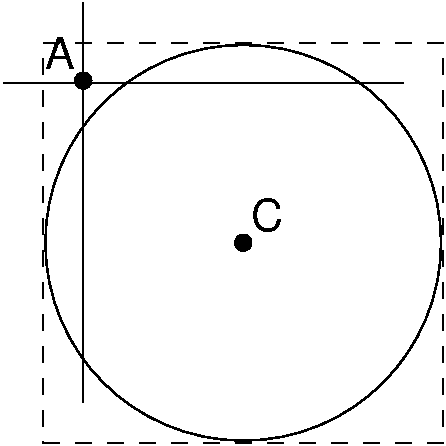
Figure 19.3.3: 函数 InCircle 必须检查记录与查询点之间的欧几里得距离。
记录 \(A\) 的 \(x\) 坐标和
\(y\) 坐标可能都在查询点 \(C\) 的查询距离内,
但 \(A\) 本身却位于查询
圆之外。
下面是构建 kd 树的可视化演示。

